第6章 実装:データ構造と連携
6-1 Clayにデータを残さない。結果はMA・SFAに書き戻す
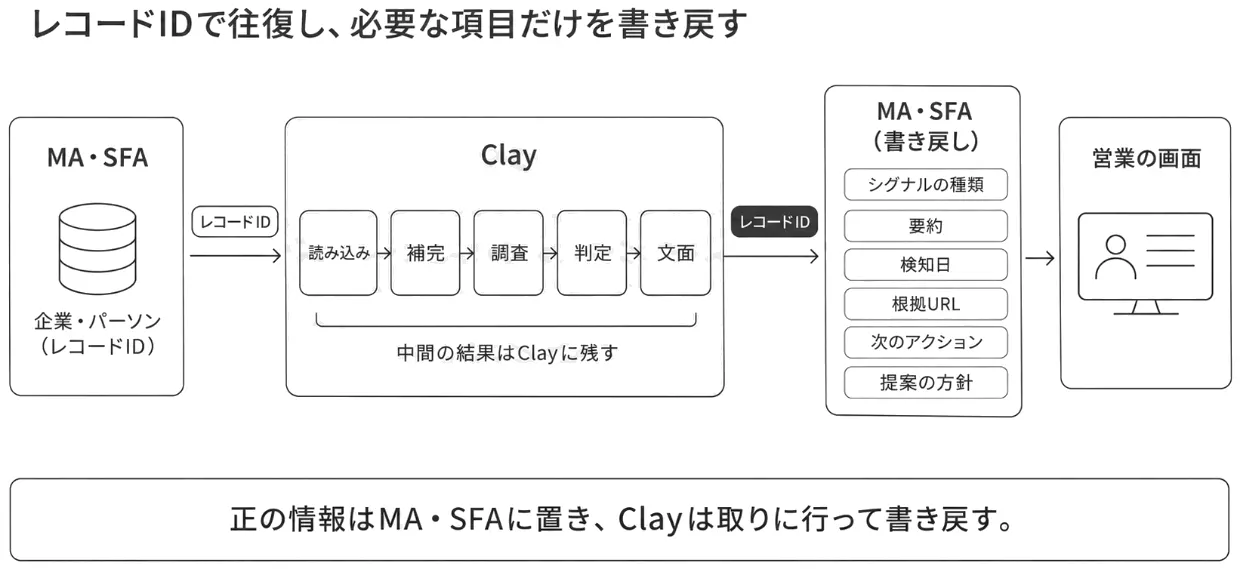
第2章で述べたとおり、ClayClay企業やパーソンについて外にある情報を集め、AIで判断し、文面を作り、MA・SFAに書き戻す、営業・マーケティング向けのデータ処理ツール。画面は表計算ソフトに似ており、1行が1社または1人、1列が1つの問いに対応する。米国のClay Labs社が提供する。用語集で見る →は試行のための場所であり、正とする顧客情報はMAMAマーケティングオートメーションマーケティングの実行と管理のための業務アプリケーション。用語集で見る →・SFASFAセールスフォースオートメーション営業の実行と管理のための業務アプリケーション。用語集で見る →に置く。データは、MA・SFAとClayの間を次の3つの順で動く。
- 読み込み:MA・SFAから対象の企業・パーソンをClayに読み込む。このとき、MA・SFA側のレコードIDを必ず一緒に持ち込む
- 処理:Clayの中で補完・調査・判定・文面生成を行う。中間の結果(ウォーターフォールウォーターフォールWaterfall1つの問いに対して、複数のデータベンダーを順番に当てるデータ取得の方式。最初のベンダーで答えが見つかればそこで止まり、見つからなければ次へ進む。単一のベンダーより取得率が上がり、見つかった時点で止まるため後続のベンダーの利用料もかからない。用語集で見る →の各ベンダーの返答、ClaygentClaygentクレイジェントClayの機能の一つで、利用者が書いたプロンプト(自然文の指示)に対して、Webサイトを読んで答えを返すAIエージェント。データベンダーには載っていない「この企業が今何に取り組んでいるか」を企業ごとに調べ、根拠となるURLも返す。用語集で見る →の生の回答文など)はClayに残す
- 書き戻し:判断と行動に必要な結果だけを、レコードIDをキーにMA・SFAの該当項目に書き戻す
企業やパーソンの突合は、1で持ち込んだレコードIDで行う。名前やメールアドレスでの照合は使わない。IDで書き戻せば、同じ企業が二重に作られることも、別の企業に書き込まれることもない。新規に見つけた企業・パーソン(5-1、5-2のターゲットリスト作成など)だけは、MA・SFA側に存在しないため、作成の前にドメインとメールアドレスで既存レコードの有無を確認する手順を入れる。
この流れを守ると、Clayのテーブルをいつ捨てても、MA・SFAの中の情報は残る。第2章で述べた「小さく試し、残ったものだけを反映する」進め方は、この構造があって成り立つ。
突合にClayの内部IDを使わない理由も記しておく。Clayの企業IDはLinkedInの会社ページを基準に振られ、同じドメインでもページが違えば別のIDになる。通常のテーブルの重複除去は列の完全一致で判定し、大文字小文字や空白の違いも別物として扱うため、表記の揺れは吸収しない。日本企業の多くはLinkedInページを持たないので、この仕組みは日本企業では機能しない。企業・パーソンの同一性は、MA・SFA側のレコードIDと、第3章3-6で述べたキー(企業は法人番号法人番号国税庁が全法人に付番する13桁の番号。企業の名寄せに使える公的キー。用語集で見る →またはドメイン、パーソンはメールアドレス)で判断する。
6-2 何をシグナルにするか
第5章で、何をするかは決まっている。実装で次に決めるのは、そのために取りに行くシグナルシグナル顧客企業に起きた変化を示す情報。経営方針・組織・キーパーソン・採用・投資と業績・事業・導入ツールと体制・外部環境の変化があり、多くは公開されている情報から得られる。用語集で見る →を、自社の商材に合わせて具体的に列挙することである。第4章の7種類のシグナルは一般的な分類であり、実際に列を組むときは、自社の商材にとって「これが出ていれば動く」という事実まで落とす。
例を3つ挙げる。
例1 人材サービス(派遣・紹介・求人媒体)
取りに行くのは、相手が人を必要としている事実である。求人媒体での募集件数の増加、特定職種の大量募集(例:1か月に同職種10件以上)、新拠点の開設、事業拡大の発表、採用責任者の着任。これらはいずれも求人媒体、ニュースリリース、適時開示、人事異動の公開情報から取れる。募集件数は数値として取れるため、「前月比で増えた企業」という条件で絞れる。
例2 販売パートナー候補の判断
取りに行くのは、相手が自社と組んだときに売れるかどうかを判断できる事実である。最初に読むのは相手のWebサイトの納入事例・導入事例で、どの業種のどんな顧客に何を納めているかを確認する。そこから、取り扱い商材が自社の商材と競合するのか補完するのか、主要顧客の業種はどこか、既に提携している企業はどこかを読み取る。加えて、直近の新規事業の発表と展示会への出展を取る。この場合のシグナルは「変化」より「現状の把握」に近く、Claygentへの問いも「〜しているか」より「〜は何か」の形になる。
例3 製造業向けの設備・装置
取りに行くのは、相手の生産体制が変わる事実である。工場の新設・増設、設備投資の発表、生産拠点に関わる職種(生産技術、品質管理、設備保全)の採用、環境対応や省エネに関する目標の公表。ニュースリリース、有価証券報告書の設備投資の項、地方紙、求人媒体から取れる。
3つの例に共通するのは、シグナルを「商材が売れる状況になった事実」として定義していることである。この定義ができると、Claygentに立てる問い、取得の頻度、そして次の6-3で決める書き戻しの項目が決まる。
6-3 書き戻し項目の設計:営業が使う形にする
Clayが取った情報を全部書き戻すと、営業は読まない。書き戻すのは、判断と行動に必要なものに絞る。
書き戻す項目
企業単位では、シグナルの種類(選択肢)、シグナルの要約(3行以内)、検知日(日付型)、根拠URL、重要度の判定結果、次のアクションの推奨、提案の方針。パーソン単位では、確認・補完した役職と部署、推定した購買グループ購買グループユニット企業内部にある検討の単位。所属と行動の同一性から認定する。BtoBの購買は一人では決まらないため、リードではなくこの単位で捉える。用語集で見る →の役割、その人向けの文面の下書き。
書き戻さない項目
ウォーターフォールの各ベンダーから返った生データ、Claygentの回答の全文、判定の途中で使った中間のスコア、条件に合わず対象外になった企業の調査結果。これらはClayに残し、必要なときにClay側で見る。
項目の形
自由記述の長文は読まれず、検索にも使えない。種類は選択肢に、日付は日付型に、要約は文字数を区切る。SFAのレポートやビューで「今週シグナルが出た企業」「種類が拠点新設の企業」と絞り込めるように、構造を持たせる。
更新のタイミング
シグナルの検知は、対象企業に対して週次または日次で実行し、新しいシグナルが出た企業だけを書き戻す。前回と同じ結果を毎回上書きすると、更新日時が意味を持たなくなる。補完した属性情報は、四半期に1回の頻度で見直す。
通知
SFAに書くだけでは気づかれない。Slackかメールで担当者に通知するか、SFAのタスクとして割り当てる。頻度は、シグナルが出るたびの即時か、日次でまとめるかを、営業の人数と1日に出るシグナルの数で決める。
この設計は、第5章の各ユースケースの「出力先」の列を、項目の単位まで具体化したものである。
6-4 シグナル履歴の持ち方
シグナルは、1社について時間とともに複数出る。拠点の新設を発表した3か月後に、その拠点の採用が始まり、半年後に責任者が着任する。この流れが見えると、相手がどのフェーズにいるかの判断が変わる。
企業レコードの項目を上書きする方式では、最新のシグナルしか残らない。履歴を残したい場合は、2つの方法がある。
1つは、SFAの活動履歴(タスク、メモ、カスタムの活動)としてシグナルを1件ずつ記録する方法である。既存の機能で実現でき、企業のタイムラインに営業の活動と並んで表示される。営業が「この会社に何が起きてきたか」を時系列で読める。
もう1つは、シグナル専用のレコードを企業に紐づけて持つ方法である。種類、日付、根拠URL、対応の有無を項目として持ち、レポートで集計できる。「拠点新設のシグナルが出た企業のうち、3か月以内に面談できた割合」のような分析は、この方法でないと出せない。
どちらを選ぶかは、分析の必要性で決める。最初は活動履歴で始め、第7章の改善サイクルでシグナルの種類ごとの効果を比べる必要が出てきたら、専用レコードに移すのが現実的である。
6-5 データ基盤(BigQuery等)との組み合わせ
ここまでは、Clayの外にあるWeb上の公開情報を取りに行く話だった。もう1つ、自社の中に蓄積されているが、MA・SFAには入りきらない情報がある。Webサイトの行動履歴、メールの開封と反応、ウェビナーの参加と視聴時間、商談や通話の記録、ECサイトの購買履歴。これらはアクティビティデータと呼ばれ、件数が多く、MA・SFAの項目に持ち続けるには向かない。多くの企業では、BigQueryなどのデータ基盤に蓄積されている。
自社サイトへの訪問については、Clay自身にもWeb Intentという機能がある。自社サイトにスクリプトを設置し、訪問者のIPアドレスを複数の判定ベンダー(Snitcher、Demandbase、Dealfront、Warmlyなど)にウォーターフォールで当てて、訪問した企業を特定する。特定できるのは企業単位までで、パーソンは特定しない。取れるのは閲覧ページ、滞在時間、流入元である。課金は特定に成功した固有IPごとで、同一IPからの訪問は30日に1回までしか課金されない。
日本企業を主な対象にする場合、Web Intentには2つの制約がある。1つは、判定ベンダーが北米・欧州の企業に強く、日本企業のIPの特定率が英語圏より下がることである。もう1つは、在宅勤務の家庭回線やVPN経由の訪問を企業として特定できないことで、これは国内外を問わない。したがって日本企業の訪問は、MA側の訪問企業判定(国内ベンダーのIP判定を含む)とデータ基盤に蓄積した行動履歴を正とし、Web Intentは外資系企業と海外からの訪問の補完に使う。特定した企業は、6-1のとおりドメインでMA・SFAのレコードに突き合わせる。
Clayは、このデータ基盤と直接つなげる。Web Intentで取った訪問も、データ基盤の行動履歴も、Clayの行に並べる方法は同じである。BigQueryに対しては、SQLMQL/SQLMarketing Qualified Lead/Sales Qualified LeadMQLはマーケティングが有望と判定したリード、SQLは営業が対応対象として受理したリード。用語集で見る →で条件を指定してレコードを読み込み、処理した結果をBigQueryのテーブルに書き戻す連携が標準で用意されている。読み込みは1回の実行で5万行までという上限があるため、BigQuery側でSQLで集計してから渡す。生のログはそのまま渡さない。例えば、「企業ごとに、直近90日のWeb閲覧ページ数、メール反応回数、ウェビナー参加の有無、最終商談日」を1行にまとめ、企業単位のテーブルにしてClayに読み込む。
この構成で、1行の中に2種類のシグナルが並ぶ。外のシグナル(Web公開情報から取った拠点新設や採用)と、内のシグナル(自社との接点接点タッチポイント顧客と自社の間で起きる相互作用のすべて。マーケティング接点・営業接点・カスタマーサクセス接点・パートナー接点があり、商談も接点の一つである。用語集で見る →の蓄積)である。両方を見て判定すると、「拠点新設を発表し、かつ直近30日で自社の製品ページを複数回見ている企業」のように、相手側の変化と自社への関心の両方が揃った企業を選べる。外のシグナルだけでは、関心があるかは分からない。内のシグナルだけでは、なぜ今かが分からない。
データ基盤はClayの入力であると同時に、結果の保管先にもなる。シグナルの履歴(6-4)を長期間、全量で持ちたい場合は、BigQueryに書き戻しておき、MA・SFAには直近の要約だけを置く構成が取れる。ただし、営業が見る正の情報はMA・SFAに置くという第2章の立場は変わらない。
6-6 国内データベンダー・LinkedIn・Webリサーチの結果を同じ項目に統一する
日本企業を対象にする場合、企業・パーソンの情報は複数の出所から集まる。MA・SFAに既に入っている国内データベンダーデータベンダー企業・パーソンの属性情報(業種、規模、所在地、法人番号、役職、連絡先など)を持ち、提供する事業者。得意な地域・業種・企業規模がそれぞれ異なる。Clayは情報そのものを持たず、複数のベンダーから取り出して組み合わせる。用語集で見る →(uSonar、Sansan DataHubなど)の属性、Clayのウォーターフォールで海外ベンダーから補完した属性、LinkedInから取った役職と異動、ClaygentがWebから読み取った情報。
出所が違うと、同じ「従業員数」でも、連結と単体、取得時期、桁の表記が異なる。同じ「役職」でも、日本語の正式名称と英語の略称が混ざる。これをそのままMA・SFAに書き戻すと、項目の中身が揃わず、絞り込みに使えなくなる。
統一の原則は3つある。
- 優先順位を決める:同じ項目に複数の出所から値が来た場合、どれを採用するかを決めておく。日本企業の基本属性は国内ベンダーを優先し、空欄のときだけ海外ベンダーの値で埋める。役職は、Webの役員一覧や公式発表を優先し、LinkedInは補完に使う
- 出所と取得日を項目として残す:値だけでなく、「どこから」「いつ」取ったかを別項目に持つ。値が食い違ったときに、どちらが新しいかで判断できる
- 表記を変換してから書き戻す:従業員数は単体に統一する、役職は自社で決めた区分(役員/部長級/課長級/担当)に変換する、といった変換をClayの列で行い、MA・SFAには変換後の値だけを入れる
この整理は、第3章3-6で述べた突合のキー(企業は法人番号またはドメイン、パーソンはメールアドレス)と合わせて、実装の初期に決めておく。後から統一しようとすると、既に書き戻した値を全部直すことになる。
次章では、組んだ仕組みを運用し続けるための、コスト・品質・ガバナンスを扱う。