第3章 Clayの基本構造:ウォーターフォールで積み上げる
3-1 テーブルと列:1列が1つの問い
ClayClay企業やパーソンについて外にある情報を集め、AIで判断し、文面を作り、MA・SFAに書き戻す、営業・マーケティング向けのデータ処理ツール。画面は表計算ソフトに似ており、1行が1社または1人、1列が1つの問いに対応する。米国のClay Labs社が提供する。用語集で見る →の基本単位はテーブルである。1行が1社または1人に対応し、1列が1つの問いに対応する。「この会社の正式名称は何か」「従業員数は何人か」「この人の現在の役職は何か」「直近1年で新しい拠点を開設したか」。問いを1つ決めるごとに列を1つ足す。
行の起点は3通りある。MAMAマーケティングオートメーションマーケティングの実行と管理のための業務アプリケーション。用語集で見る →・SFASFAセールスフォースオートメーション営業の実行と管理のための業務アプリケーション。用語集で見る →から対象の企業やパーソンを読み込む、手元のCSVを取り込む、Clayの中で条件を指定して企業を検索する、である。既存の顧客やリードを扱う場合は前者2つ、新しい対象を探す場合は後者を使う。
列には、入力の列と、処理の結果が入る列がある。企業名とドメインが入力の列であれば、そこを起点に従業員数の列、業種の列、採用動向の列が結果として埋まっていく。結果の列は、さらに次の列の入力になる。この連なりが、Clayで一社分の情報を組み立てる仕組みである。
3-2 ウォーターフォール:1つの問いに、複数のデータソースを順番に当てる
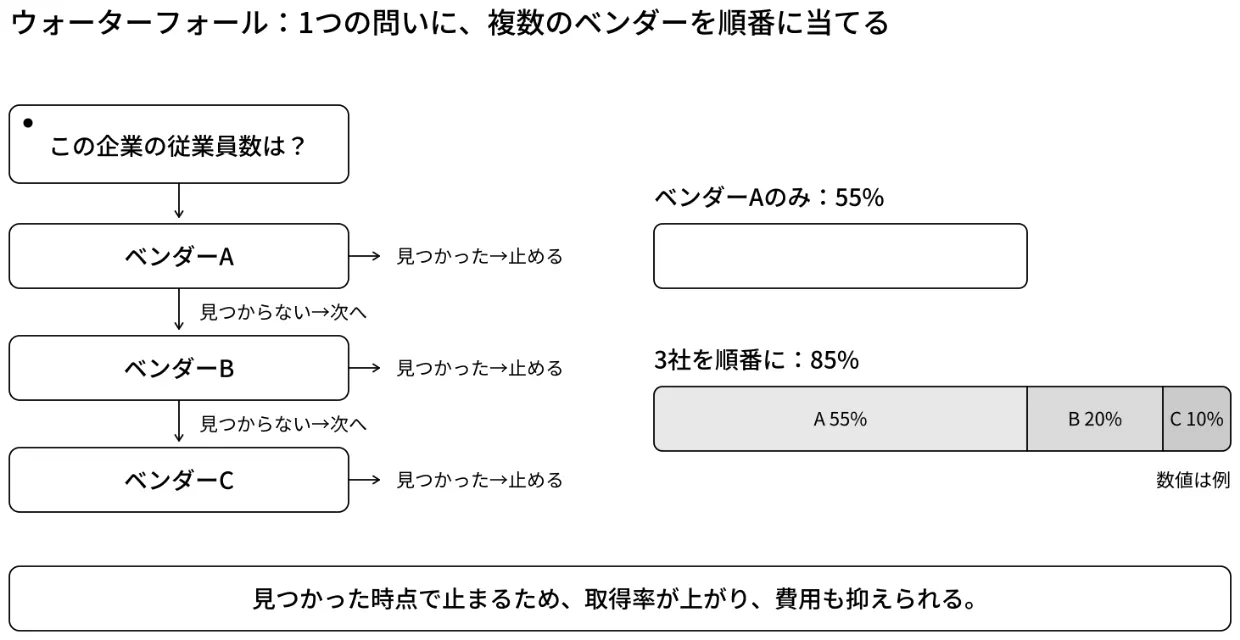
Clayのデータ取得の中心にあるのが、ウォーターフォールウォーターフォールWaterfall1つの問いに対して、複数のデータベンダーを順番に当てるデータ取得の方式。最初のベンダーで答えが見つかればそこで止まり、見つからなければ次へ進む。単一のベンダーより取得率が上がり、見つかった時点で止まるため後続のベンダーの利用料もかからない。用語集で見る →(Waterfall)と呼ばれる方式である。
1つの問いに対して、複数のデータベンダーデータベンダー企業・パーソンの属性情報(業種、規模、所在地、法人番号、役職、連絡先など)を持ち、提供する事業者。得意な地域・業種・企業規模がそれぞれ異なる。Clayは情報そのものを持たず、複数のベンダーから取り出して組み合わせる。用語集で見る →を順番に当てる。最初のベンダーで答えが見つかればそこで止まり、見つからなければ次のベンダーに進む。例えば「この企業の従業員数」という問いに対して、ベンダーAで見つかれば終了、見つからなければベンダーB、それでも見つからなければベンダーCと進む。
この方式には2つの利点がある。
1つは取得率が上がることである。データベンダーにはそれぞれ得意な地域、業種、企業規模があり、1社のベンダーで取れる情報には限りがある。複数のベンダーを連ねると、1社目で取れなかった分を2社目以降が埋めるため、全体の取得率は単一ベンダーより高くなる。
もう1つはコストを抑えられることである。見つかった時点で止まるため、後続のベンダーの利用料は発生しない。精度が高く安いベンダーを先に、精度は高いが高いベンダーを後に置けば、多くの行は先に置いたベンダーで埋まり、高いベンダーは本当に必要な行にだけ使われる。
ウォーターフォールは、Clayがあらかじめ用意している組み合わせをそのまま使うこともできるし、自社の対象企業に合わせてベンダーの順番と組み合わせを変えることもできる。どのベンダーが自社の対象に強いかは、実際に数十社で試して取得率を見れば分かる。
3-3 列を積み上げて、一社分の情報を組み立てる
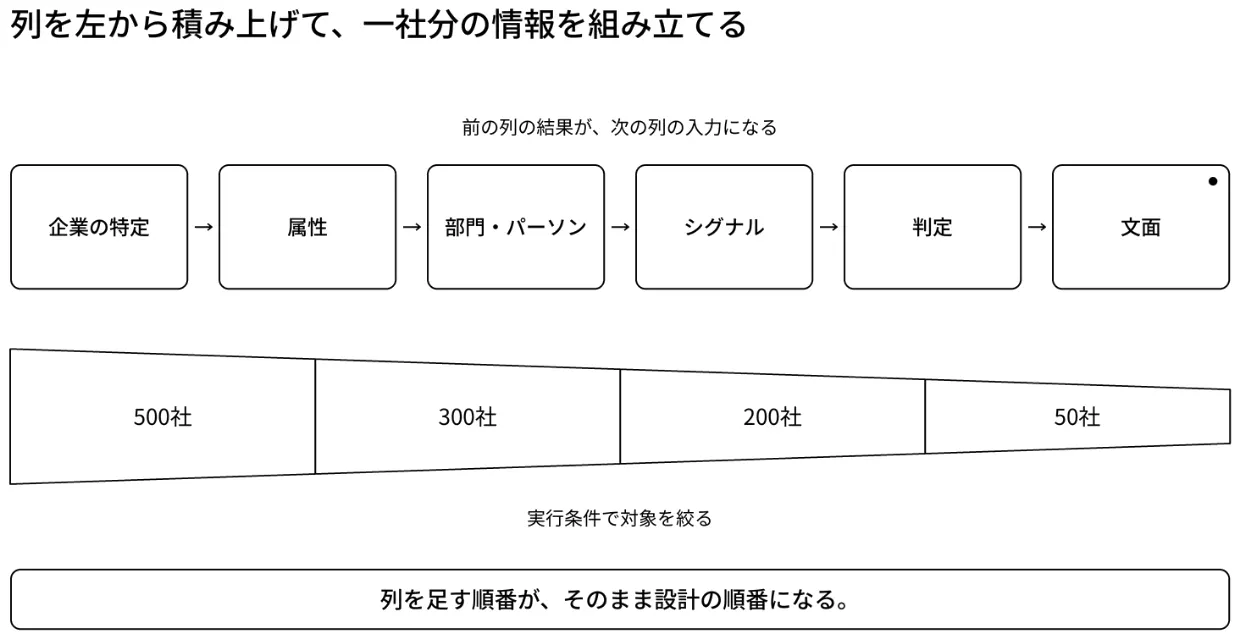
ウォーターフォールが「1つの問いへの答え方」だとすれば、列の積み上げは「問いを順番に並べて一社分の情報を組み立てる方法」である。
典型的な順番は次のとおりである。
- 企業の特定:企業名から正式名称とWebサイトのドメインを確定する。ここが定まらないと、以降の列が別の会社の情報を取ってくる
- 企業の属性:業種、従業員数、売上規模、所在地、上場区分を取得する
- 部門とパーソン:対象の部門に所属するパーソンを探し、役職と連絡先を取得する
- シグナルシグナル顧客企業に起きた変化を示す情報。経営方針・組織・キーパーソン・採用・投資と業績・事業・導入ツールと体制・外部環境の変化があり、多くは公開されている情報から得られる。用語集で見る →:採用、拠点、中期経営計画、人事異動、Webの更新など、相手側で起きていることを調べる
- 判定:ここまでの情報から、対象とするか、優先度はどうか、誰が動くかを決める
- 文面:判定で対象になった行にだけ、連絡の文面や営業への申し送りを生成する
各列は、前の列の結果を入力にして動く。企業の属性は確定したドメインを使って取り、シグナルは企業の属性と事業内容を踏まえて調べ、判定は属性とシグナルの両方を見て行う。
列には実行条件を付けられる。「従業員数が300人以上の行だけ、パーソンを探す」「シグナルが見つかった行だけ、文面を生成する」というように、条件を満たす行にだけ次の列を実行できる。これにより、全行に対して高い列を実行せずに済む。
この積み上げ方は、第2章で述べた試行に向いている。最初は企業の特定と属性の2列だけで対象企業を眺め、絞り込みの条件が決まったらパーソンの列を足し、シグナルの列を1種類ずつ試して反応を見る。どの列が判断に使えるかが分かってから、文面の列を足す。列を足す順番そのものが、設計の順番になる。
3-4 Claygent:Webを読んで答えを返す列
データベンダーが持っているのは、企業とパーソンの属性情報である。「この企業が今何に取り組んでいるか」は、ベンダーには載っていない。それを取るのがClaygentClaygentクレイジェントClayの機能の一つで、利用者が書いたプロンプト(自然文の指示)に対して、Webサイトを読んで答えを返すAIエージェント。データベンダーには載っていない「この企業が今何に取り組んでいるか」を企業ごとに調べ、根拠となるURLも返す。用語集で見る →(クレイジェント)である。
Claygentは、プロンプト(自然文で書いた指示)を受け取り、対象企業のWebサイト、ニュースリリース、IR資料、採用ページなどを読んで、答えと根拠のURLを返す。「この企業は直近12か月以内に新工場または新拠点の開設を発表しているか。発表していれば、場所と時期を答えよ」という問いに対して、企業ごとに答えが返る。
問いの立て方で、答えの精度が変わる。実務で精度が上がる書き方は次のとおりである。
- 答えの形を指定する:「はい/いいえ」で答えさせる、場所と時期を分けて答えさせる、など。形が揃っていれば、次の列で条件分岐に使える
- 期間を限定する:「直近12か月以内」「2025年以降」と区切る。区切らないと古い情報を取ってくる
- 見つからない場合の答えを決めておく:「該当する情報が見つからない場合は『不明』と答えよ」と書く。これがないと、無理に答えを作る
- 根拠を返させる:答えとともにURLを返させ、人が確認できるようにする
Claygentは、Clayが用意したWebリサーチ用のモデル(Helium、Argon、Neon)で動き、実行のたびにデータクレジットデータクレジット/アクションClayの利用料に含まれる2種類の単位。データクレジットは外部のデータベンダーから情報を取得するたびに、アクションは列の実行・条件分岐・他システムへの書き込みなど、Clayの中で処理を1つ動かすたびに消費する。2つは別々に減り、どちらかが先に尽きる。用語集で見る →を消費する。同じ列で、OpenAI、Anthropic、Googleのモデルに切り替えることもできる。Webを広く読んで要約する問いと、決まった形で短く答えさせる問いでは、向くモデルと消費量が違うため、問いの種類に応じて使い分ける。また、有料プランでは、自社で契約しているOpenAIやAnthropicのAPIキーをClayに登録し、そのモデルでWebリサーチや文面生成を動かせる。この場合、AIの利用料は自社の契約側で支払い、Clayのデータクレジットは消費しない。処理ごとのアクション(3-5)は消費する。Clay社の教材によれば、利用者の9割が自社のAPIキーを登録している。情報の取り扱いを自社の契約条件に合わせたい企業、既にAIの利用枠を持っている企業は、この方法を取る。
Claygentの答えは、そのまま信じて使うものではない。最初は数十社分の答えと根拠URLを人が読み、誤りの傾向を見つけ、問いの書き方を直す。精度が安定してから、対象を数百社・数千社に広げる。この確認の手順は第7章で扱う。
3-5 データクレジットとアクション:どの列にいくらかかるか
Clayの利用料は月額のプラン料金で、その中に2種類の単位が含まれる。データクレジット(Data Credits)は、データベンダーから情報を取得するたびに消費する。アクション(Actions)は、列の実行、条件分岐、他システムへの書き込みなど、Clayの中で処理を1つ動かすたびに消費する。Claygentの調査と文面生成は両方を消費する。列の種類によって1行あたりの消費量が異なり、どちらの単位を多く使うかも異なる。
消費を抑える方法は、3-2と3-3で述べた構造そのものにある。
- ウォーターフォールの順番:安く取得率の高いベンダーを先に置く
- 実行条件:消費の大きい列は、条件を満たした行にだけ実行する
- 列の順番:絞り込みに使う消費の小さい列を先に、文面生成のような消費の大きい列を最後に置く
- 再実行を避ける:一度取得した結果は保持されるため、問いの書き方を変えない限り再実行しない
月あたりの消費は、対象社数、1社あたりのパーソン数、実行する列の数と種類、更新の頻度で決まる。2つの単位の違いと見積もりの方法は第7章で示す。
3-6 日本企業データの事情
Clayに接続している海外のデータベンダーは、英語圏の企業情報には強い。日本企業については、企業の基本情報は取れるが、法人格を含む正式名称、本社と事業所の区別、担当者の氏名と部署名などは、取得率が下がる。
このため日本企業を対象にする場合は、第2章で述べたとおり、MA・SFA側に既にある国内データベンダー(uSonar、Sansan DataHubなど)の情報を読み込んで使う。業種、売上規模、従業員数、法人番号法人番号国税庁が全法人に付番する13桁の番号。企業の名寄せに使える公的キー。用語集で見る →、グループ関係といった属性はMA・SFAの項目から持ち込み、Clayの列は、そこに欠けている情報と、国内ベンダーが持っていない「今何に取り組んでいるか」を埋めることに使う。前者は海外ベンダーのウォーターフォールで、後者はClaygentで取る。
突合のキーには注意が要る。企業は、法人番号があれば法人番号で、なければWebサイトのドメインで突き合わせる。企業名の文字列は、「株式会社」の位置、略称、英文表記、旧社名で揺れるため、キーには使わない。パーソンは勤務先のメールアドレスをキーにする。氏名の表記が揺れても、メールアドレスが一致すれば同一人物として扱える。
もう1つの事情は、日本企業の公開情報の形である。採用情報は自社サイトより求人媒体に、拠点や設備投資の情報はニュースリリースより地方紙や業界紙に出ることが多い。Claygentに問いを立てる際は、どこを読ませるかを問いの中で指定すると精度が上がる。この点は第4章のシグナルの種類と合わせて扱う。
次章では、Clayで取りに行く「シグナル」と、それをWhy You NowWhy You Now「なぜ貴社に(Why You)」「なぜ今(Why Now)」「なぜ私たちが(Why Us)」の3つの問いへの答え。データから導かれる接触の根拠であり、営業を動かすのはリードの数やスコアではなくこの理由である。用語集で見る →につなげる「コンテキストコンテキストその顧客が今どんな状況にあり、なぜそれを求めているのかを説明するための情報。業種や規模と違い一社ごと・一人ごとに異なり、シグナル・自社接点・購買グループを組み合わせて組み立てる。用語集で見る →」を説明する。