第7章 4つのデータソースをフル活用する ―― コンテキストのもとになる情報を、どこから得るか
第6章で、コンテキストコンテキストその顧客が今どんな状況にあり、なぜそれを求めているのかを説明するための情報。業種や規模と違い一社ごと・一人ごとに異なり、シグナル・自社接点・購買グループを組み合わせて組み立てる。用語集で見る →とWhy You NowWhy You Now「なぜ貴社に(Why You)」「なぜ今(Why Now)」「なぜ私たちが(Why Us)」の3つの問いへの答え。データから導かれる接触の根拠であり、営業を動かすのはリードの数やスコアではなくこの理由である。用語集で見る →を定義した。MAMAマーケティングオートメーションマーケティングの実行と管理のための業務アプリケーション。用語集で見る →・SFASFAセールスフォースオートメーション営業の実行と管理のための業務アプリケーション。用語集で見る →のデータだけではコンテキストは組み立てられない。では、何を、どこから集めればよいのか。本章では、顧客について得られるデータを4つのソースに整理し、それぞれをどう活用するかを述べる。あわせて、第6章で「そもそも記録されていない」と述べた営業と顧客のやり取りを、AIでどう記録するかを扱う。
7-1. MA・SFAのデータだけでは、顧客の全体像は見えない
顧客について得られるデータは、MAとSFAの中にあるものだけではない。むしろ、MAとSFAに入っているデータは、顧客について知り得る情報のごく一部である。
顧客企業のWebサイトを訪れる人物の行動、企業データベースが持つ属性、企業が公開している経営情報、営業が顧客と交わした会話。これらは、それぞれ別の場所にあり、別の形をしている。だが、すべて同じ顧客についての情報である。第3章で述べたSSOTSSOTSingle Source of Truth項目ごとに「どこが正か」が一意に定まった状態。全データを1箇所に集めることを意味しない。用語集で見る →によって顧客が一つに確定していれば、これらを一人の顧客のもとに集めることができる。
問題は、どこに何があるかを整理せずに「データを集めよう」とすることである。何のために、どのデータを、どこから集めるのかが決まっていなければ、集めたデータは使われない。本章ではまず、データソースを役割で整理する。
7-2. 4つのデータソースと、それぞれの役割
本書では、顧客について得られるデータを、それが顧客について何を教えてくれるかという役割で4つに分ける。
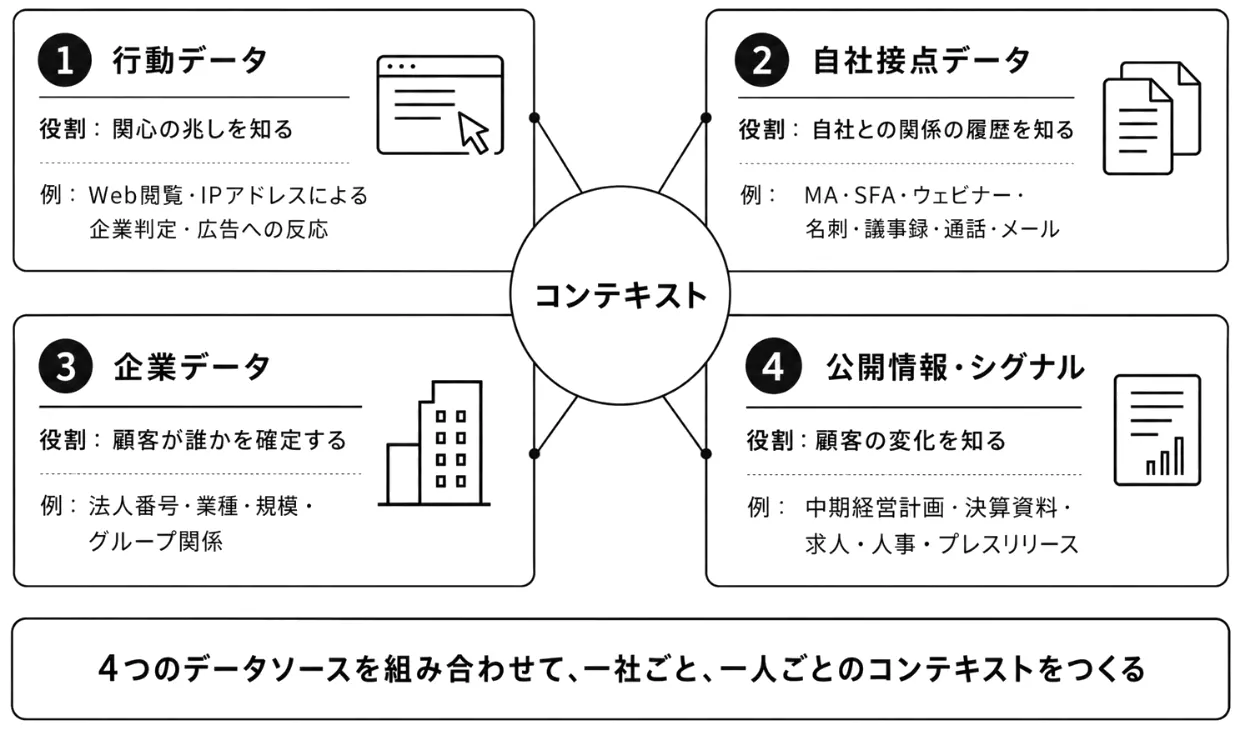
| データソース | 主な中身 | 役割 |
|---|---|---|
| 行動データ | Webサイトの閲覧、クッキー、IPアドレスによる企業判定、広告への反応 | 関心の兆しを知る |
| 自社接点データ | MA・SFAの記録、イベント・ウェビナー、名刺、議事録、通話、メール | 自社との関係の履歴を知る |
| 企業データ | 企業データベースの属性、グループ・拠点情報、法人番号 | 顧客が誰かを確定する |
| 公開情報・シグナル | IR資料、中期経営計画、プレスリリース、採用情報、人事、ニュース | 顧客の変化を知る |
一般には、データを「自社が持つもの」と「他社から得るもの」で分けることが多い。だがその分け方では、顧客企業が公開している情報の位置づけが曖昧になる。自社のものでも他社のものでもなく、公開されているものだからである。役割で分けることで、4つのソースがそれぞれ何のために要るのかが明確になる。
4つのソースは、互いに補い合う。企業データで「誰か」を確定し、行動データと自社接点接点タッチポイント顧客と自社の間で起きる相互作用のすべて。マーケティング接点・営業接点・カスタマーサクセス接点・パートナー接点があり、商談も接点の一つである。用語集で見る →データで「自社との間に何があったか」を知り、公開情報・シグナルシグナル顧客企業に起きた変化を示す情報。経営方針・組織・キーパーソン・採用・投資と業績・事業・導入ツールと体制・外部環境の変化があり、多くは公開されている情報から得られる。用語集で見る →で「今、何が起きているか」を知る。どれか一つが欠けても、コンテキストは組み立てられない。
7-3. 行動データを活かす:匿名の行動を、企業とパーソンに結びつける
行動データは、顧客の関心が最初に表れる場所である。
Webサイトに誰かが来て、製品ページを見て、事例を読み、価格のページに至る。この一連の行動は、その人物が何かを検討し始めた兆しである。だが多くの場合、その人物が誰かは分からない。フォームを送信する前の行動は、匿名だからである。
行動データを活かすには、匿名の行動を企業とパーソンに結びつける必要がある。
企業への結びつけは、IPアドレスによる企業判定で行う。アクセス元のIPアドレスから、どの企業のネットワークからのアクセスかを判定する。個人は特定できないが、「ある企業から、先週、MA導入の事例ページが5回閲覧された」ことは分かる。これは第5章で述べた購買グループ購買グループユニット企業内部にある検討の単位。所属と行動の同一性から認定する。BtoBの購買は一人では決まらないため、リードではなくこの単位で捉える。用語集で見る →の発掘における、匿名接触者の手がかりである。
パーソンへの結びつけは、その人物が何らかの形で自らを明かした時点で行う。フォームを送信する、メールのリンクをクリックする、ウェビナーに登録する。その瞬間に、それまでの匿名の行動履歴がそのパーソンに紐づく。MAはこの結びつけを標準で行う。
ただし、行動データには制約がある。クッキーの利用は各国の規制と各ブラウザの仕様によって制限が強まっており、匿名の行動を長期にわたって追うことは難しくなっている。行動データは「関心の兆しを知る」ための最初の手がかりであり、それだけで顧客を理解しようとするべきものではない。兆しを捉えたら、他のソースと組み合わせる。
7-4. 自社接点データを厚くする:営業接点はAIで記録する
自社接点データは、4つのソースの中で最も自社に固有であり、他社が持ち得ないものである。競合は、顧客企業の公開情報を同じように見ることができる。企業データベースも同じものを買える。だが、自社の営業が顧客と交わした会話は、自社にしかない。
にもかかわらず、第6章で述べたとおり、営業と顧客のやり取りの多くは、CRMCRMCustomer Relationship Management顧客との関係と取引履歴を管理する仕組み。GTMの4レイヤーでは、SFA・MAと並ぶ業務アプリケーション層に位置づけられる。用語集で見る →に記録されていない。議事録は営業担当者のノートに、電話の内容は記憶に、メールはメールソフトの中に残ったままである。自社にしかないデータが、自社の中でも一人の担当者にしかない。これが、自社接点データの最大の問題である。
解決の方向は、「入力を定着させる」ことではない。第2章で述べたとおり、それは長年試みられ、機能しなかった。解決の方向は、記録を自動にすることである。営業は会話に集中し、記録はAIが行い、営業は記録された内容を確認する。「記録は自動、判断は人」。この分担に変える。
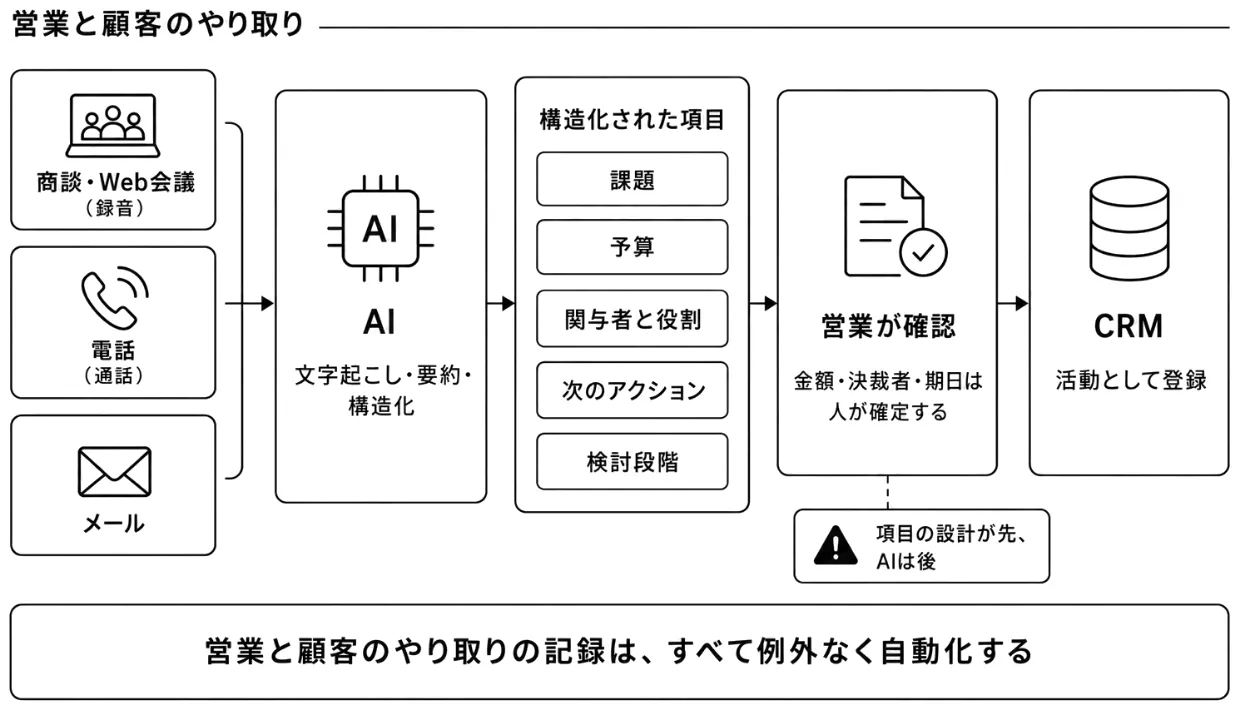
商談・Web会議。 対面の商談やWeb会議を録音し、AIが文字起こしと要約を行い、議事録を自動で生成する。生成された議事録は、その商談に紐づく活動としてCRMに登録される。営業がやることは、録音を始めることと、生成された議事録を確認することだけである。
電話。 電話の通話を文字起こしし、AIが要約して、活動履歴として自動で残す。インサイドセールスインサイドセールス訪問せずに電話やメールで見込み客と接点を持つ営業機能。聞き取りで得た情報は、フォームからは分からない購買グループの手がかりになる。用語集で見る →の架電では、一日に数十件の通話が発生する。その一つひとつを人が入力することは現実的ではないが、自動であれば全件が残る。
メール。 営業と顧客の間のメールを自動で取り込み、送信者と受信者のメールアドレスをもとに、パーソンと商談に紐付ける。CCに含まれる人物は、第5章で述べた購買グループの発掘の手がかりとして、パーソンの候補に加える。
会話の中身を構造化する。 議事録や通話の要約は、そのままでは読み物である。第4章で定義した項目に沿って、AIが構造化する。顧客が語った課題、予算の有無や規模、関与している人物とその役割、次のアクション、検討の段階。これらを議事録から抽出し、それぞれの項目に入れる。ここで重要なのは、項目の設計が先で、AIは後だという順序である。何を抽出するかが第4章の定義として決まっていなければ、AIは要約を作るだけで、データは生まれない。
誤要約への備え。 AIの要約は、常に正しいとは限らない。金額を聞き違える、発言者を取り違える、決まっていないことを決まったように書く。重要な項目、とくに金額、決裁者、期日については、営業が確認してから確定する運用にする。AIが提示し、人が承認する。この手順を省くと、誤ったデータが正しいデータとして流通する。
営業接点がAIで記録されるようになると、自社接点データは質と量の両方で変わる。これまで一人の営業の記憶にあった情報が、組織の資産になる。そして第6章で述べたとおり、シグナルや購買グループの情報と組み合わせて、コンテキストとして使えるようになる。
7-5. 企業データの補完:いつ補完するかを設計する
企業データは、第3章で詳しく述べた。法人番号法人番号国税庁が全法人に付番する13桁の番号。企業の名寄せに使える公的キー。用語集で見る →で企業を確定し、企業データベースから業種、規模、グループ関係といった静的な属性を補完する。ここでは、補完をいつ行うかという設計上の論点を加えておく。
補完のタイミングには2つの考え方がある。
登録時に補完する。 新しい企業やパーソンがMAやSFAに入ってきた時点で、企業データベースに照合し、属性を付けてから保存する。入ってくるデータが最初から揃っているため、その後の処理が簡単になる。フォームの送信やイベントでの名刺交換など、データが入ってくる経路が限られている場合に向く。
保存後に補完する。 まずデータを保存し、定期的にまとめて企業データベースと照合して属性を更新する。経路が多く、リアルタイムの照合が難しい場合に向く。既存のデータを一括で整備する場合もこの方法になる。
実務では両方を組み合わせる。登録時に最低限の照合を行い、法人番号を確定する。属性の詳細と定期的な更新は、保存後にまとめて行う。第3章で述べたコネクターがあれば、どちらも自動化できる。
7-6. 公開情報をシグナルに変える:Webリサーチによるエンリッチ
公開情報は、4つのソースの中で最も量が多く、最も構造化されていない。決算説明資料、プレスリリース、採用ページ、役員人事、業界ニュース。これらは文章として公開されており、そのままではデータにならない。
公開情報をシグナルに変える工程を、本書ではWebリサーチによるエンリッチと呼ぶ。第3章で述べたエンリッチが企業データベースから静的な属性を補完するものであったのに対し、ここでのエンリッチは、Web上の公開情報から動的な変化を補完するものである。
この工程を担う仕組みとして、Clayに代表されるツールがある。対象とする企業のリストを入力すると、Web上の情報源を巡回し、あらかじめ定めた観点(中期経営計画の内容、役員人事、採用職種、導入ツールなど)について情報を収集し、企業ごとに整理して返す。さらにAIを組み合わせることで、収集した文章から「変化」に該当する箇所を抽出し、第6章で述べた種別・日付・対象・根拠・自社の提供価値との関係の形に構造化する。
ここで重要なのは、観点をあらかじめ定めることである。「ある企業について調べる」では、AIは何を探せばよいか分からない。「その企業の直近の中期経営計画に、デジタルマーケティング、営業のデジタル化、顧客データの活用に関する記述があるか。あれば該当箇所と発表日を抽出せよ」という観点があって初めて、シグナルとして使える情報が返ってくる。観点は、自社の提供価値から逆算して定める。自社が応えられる課題は何か。その課題が生まれる変化は何か。その変化は、どんな公開情報に表れるか。この逆算が、Webリサーチの設計である。
7-7. 4つを統合する設計:どのソースを、どの単位に、どの鮮度で
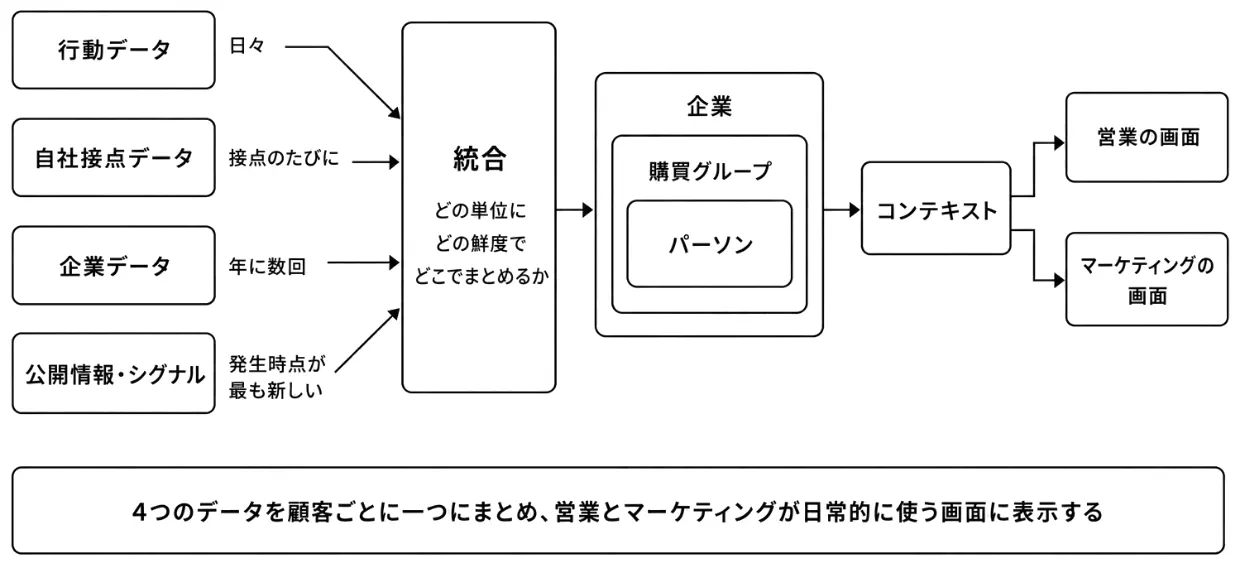
4つのソースからデータが集まるようになると、次の問題は統合である。それぞれのソースは、単位も鮮度も違う。
単位。 行動データはパーソンまたは企業の単位で発生する。自社接点データはパーソン、購買グループ、商談のいずれかに紐づく。企業データは法人や事業所の単位である。公開情報・シグナルは企業の単位で発生するが、内容によっては部門まで特定できる。これらを、第4章で述べたデータ構造のどの単位に紐付けるかを、ソースごとに決める。
鮮度。 行動データは日々発生し、数日で価値が下がる。自社接点データは接点のたびに発生し、履歴として価値を持ち続ける。企業データは年に数回の更新で足りる。公開情報・シグナルは発生した時点が最も価値が高く、数か月で古くなる。それぞれの更新の頻度を決め、古くなったデータをどう扱うかを決める。
統合の場所。 4つのソースを組み合わせてコンテキストにする作業は、どこで行うか。第3章で述べたSSOTの3類型によって答えは変わる。SFA一体型ならSFAの中に、DWHDWHデータウェアハウス複数システムのデータを蓄積・統合・加工するためのデータ基盤。用語集で見る →併用型ならDWHの中に、統合の場所を置く。重要なのは、統合された結果が、営業とマーケティングが日常的に見る画面に届くことである。DWHの中で統合されていても、営業がSFAの画面でそれを見られなければ、使われない。
7-8. 量と速度と非構造データ。だからAIは切り離せない
4つのデータソースをフルに活用するとは、具体的には次のことである。日々発生する行動データを企業とパーソンに結びつける。営業接点をすべて記録し、構造化する。企業データを定期的に補完する。数百社、数千社の公開情報を追い、変化を抽出し、構造化する。そして4つを組み合わせ、顧客ごとにコンテキストを組み立てる。
これを人手で行うことは、できない。量が多すぎ、速度が追いつかず、そして扱うデータの多くが文章や音声といった非構造のものだからである。
AIは、この3つの制約を同時に解く。量については、対象が数千社でも処理できる。速度については、公開情報が出た当日に処理できる。非構造データについては、文章や音声を読み、聞き、構造化された項目に変換できる。第6章で「AIがコンテキストを組み立て、人が磨く」と述べたのは、この理由による。
AIを使わずに4つのデータソースを活用しようとすると、対象を絞るしかない。重点顧客の数十社だけを人手で追う。それは一つの方法だが、第9章で述べる大規模組織のCRMには届かない。すべての顧客について、当たり前を実現する。それがAI時代のCRMであり、AIなしには成立しない。
次章では、こうして組み立てられたコンテキストとWhy You Nowを、実際のエンゲージメントエンゲージメント顧客が自社との接触に価値を感じ、関係を続けたいと思っている状態。接触の量ではなく関係の深さを表し、企業・購買グループ・パーソンの3つの単位で捉える。CRMの目的はこれを高めることにある。用語集で見る →の施策にどう変えるかを、ユースケースとして述べる。
COLUMN
ファーストパーティ、セカンドパーティ、サードパーティとの対応
データの分類として、ファーストパーティデータ(自社が直接収集したデータ)、セカンドパーティデータ(他社が収集し、提携によって得たデータ)、サードパーティデータ(データ事業者が収集し、販売するデータ)という区分が広く使われている。本書の4分類との対応は、おおむね次のとおりである。行動データと自社接点データはファーストパーティにあたる。企業データはサードパーティにあたる。公開情報・シグナルは、企業が自ら公開しているものであり、この3区分には収まりにくい。本書が役割による分類を採用したのは、この公開情報を独立したソースとして位置づけるためである。
本章の要点
- 顧客について得られるデータは、行動データ・自社接点データ・企業データ・公開情報・シグナルの4つのソースに分けられる。それぞれ「関心の兆し」「自社との履歴」「顧客が誰か」「顧客の変化」を知る役割を持つ
- 行動データは匿名の行動を企業とパーソンに結びつけて活かす。クッキーの制約により、それだけで顧客を理解しようとはしない
- 自社接点データは自社にしかないデータでありながら、営業と顧客のやり取りの多くが記録されていない。解決の手段はAIによる自動記録。「記録は自動、判断は人」
- 議事録・通話・メールをAIで記録し、第4章の定義に沿って構造化する。項目の設計が先、AIは後。誤要約への備えを運用に組み込む
- 企業データの補完は、登録時の照合と保存後の定期更新を組み合わせる
- 公開情報は、自社の提供価値から逆算した観点でWebリサーチを行い、AIで変化を抽出してシグナルに変える
- 4つのソースは単位と鮮度が違う。どの単位に紐付け、どの頻度で更新し、どこで統合するかを設計する
- 量、速度、非構造データの3つの制約を同時に解けるのはAIだけである。AI時代のCRMは、AIなしには成立しない