
第6章 生成AI活用の実装
6-1. ユースケース選定の判断基準
土台の設計(第4章)と置き場所(第5章)が定まった。本章では、その上で何を動かすかを扱う。
最初に決めるべきは、どのユースケースから着手するかである。ここで多くの組織が同じ失敗をする。経営や現場の期待が大きいユースケース——たとえば全自動のパーソナライズ提案——から着手し、データ条件が揃っていないために精度が出ず、「うちのデータではAIは使えない」という結論だけが残る。第1章で見た「導入88%・成果6%」の差の一部は、この着手順の誤りで説明できる。
選定は、次の2軸で行う。
六つの代表的なユースケースをこの2軸に配置したものが図6-1である。
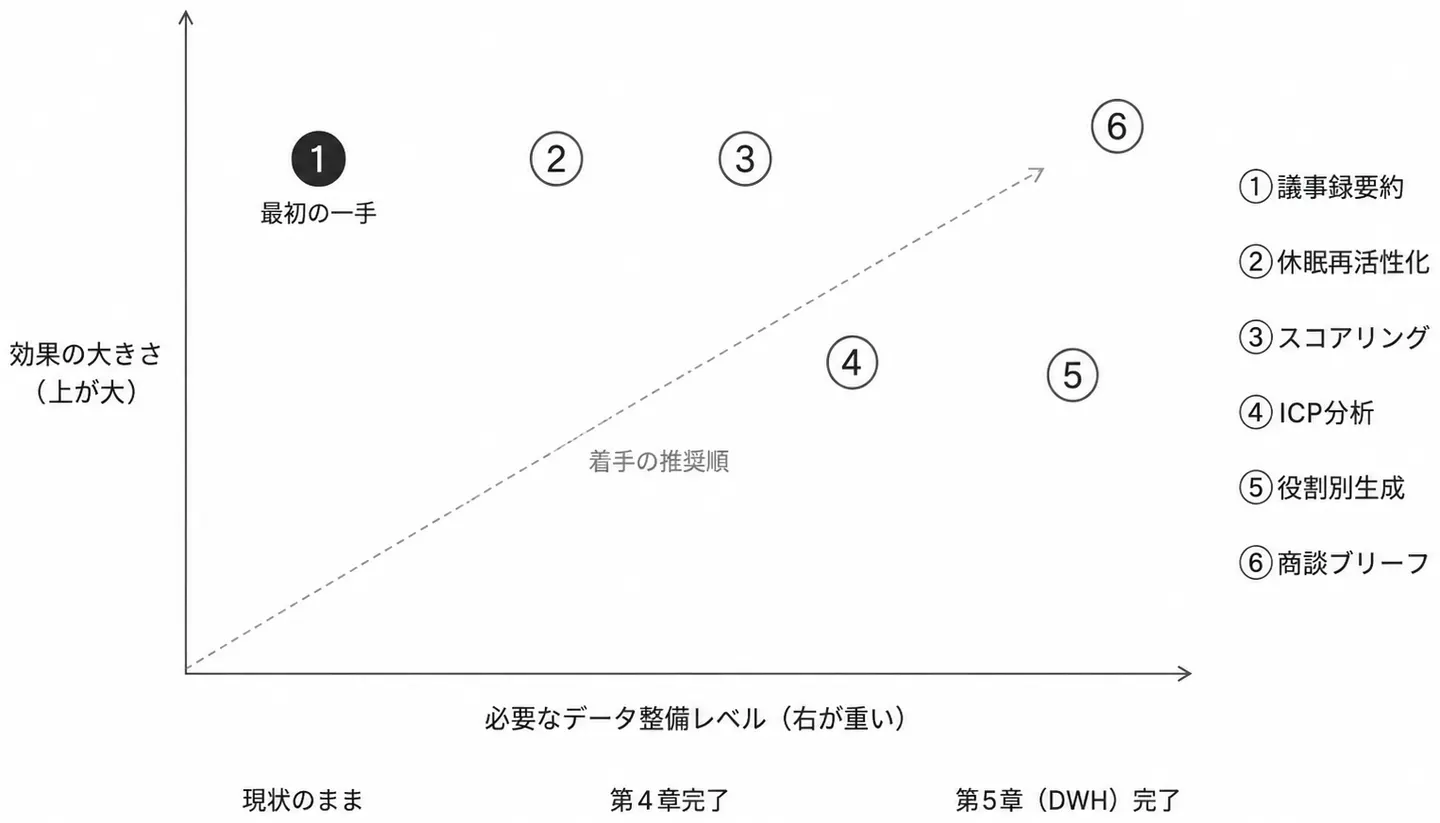
原則は明快である。「今のデータで動くもの」から始め、整備の進行に合わせて高度なユースケースを解放していく。 データ整備は第5章で述べた通り段階的に進む。整備とAI活用を直列(整備完了後にAI着手)ではなく並行で進め、各段階で動くユースケースから成果を出す——これが投資を継続させる唯一の現実解である。
もう一つの原則は、AIの出力を業務プロセスに埋め込むことである。第1章で確認した通り、成果を出している企業の共通点は「AIをコアワークフローに直接組み込んでいる」ことだった。営業が別画面を開いて使うAIは定着しない。SFAの商談画面、MAの配信設定、日常のチャットツール——すでに開いている画面の中にAIの出力が現れる設計(第5章の逆連携)を、全ユースケース共通の実装要件とする。
6-2. 実装ガイド:代表ユースケース6例
レベニューサイクルの接点順に、6つのユースケースを示す。各例は「概要/必要なデータ条件/実装の要点/落とし穴」の統一形式で記述する。データ条件の欄は、第4章・第5章のどの整備に依存するかを明示している——精度が出ない場合に疑うべき場所のリストでもある。
ユースケース① 商談議事録の要約とSFA自動入力
概要: オンライン商談の録画・音声から、AIが議事録と要約を生成し、SFAの活動記録・商談メモに自動登録する。BANT情報(予算・決裁者・ニーズ・時期)や次のアクションも構造化して抽出する。
必要なデータ条件: ほぼなし。商談の録音・録画データがあれば動く。6例の中で唯一、第4章の整備を前提としない。
実装の要点: 最初に着手すべきユースケースである。理由は三つ。データ条件が最も軽い。営業の入力負荷を直接減らすため現場が歓迎する。そして最大の理由——第3章の汚染源⑤(入力漏れ・自己流入力)を発生源から遮断する。つまりこのユースケースは、AI活用であると同時にデータ整備の施策でもある。抽出項目はSFAの項目定義と対応させ、「進行中」「検討中」といった曖昧語ではなくステージ定義(第7章)に沿った値で出力させる。
落とし穴: 自動入力を全面信頼し、営業の確認プロセスを省くこと。抽出の誤りがそのままSFAの正式記録になる。運用開始から一定期間は「AIがドラフト、営業が確認・確定」の二段構えとする。
ユースケース② 休眠リードの再活性化
概要: 過去に接点があったが放置されているリードから、再検討の兆候(サイト再訪、メール再開封)を検知し、文脈に沿ったフォローメールをAIが生成して配信する。
必要なデータ条件: パーソンの名寄せ(4-2)と陳腐化データの棚卸し(汚染源④の対策)が完了していること。動的データがMAで取得できていること。
実装の要点: 第2章で述べた「失注・休眠は再育成の入口」の実装である。営業リソースをかけずに死蔵リードが収益源に変わるため、投資対効果を最も示しやすい。生成するメールは、過去の接点の文脈(参加したセミナー、ダウンロードした資料)を参照させることで、一斉配信との違いを出す。
落とし穴: 陳腐化の清掃前に実行すること。退職者・異動者を含むリストへの配信は、到達率の悪化と受信者からの不信を招き、再活性化どころか配信基盤を毀損する(第3章)。清掃が先、配信が後——この順序は動かせない。
ユースケース③ リードスコアリングの再構築
概要: 静的データ(企業属性・役職)と動的データ(行動の種類・頻度・最近性)を掛け合わせ、営業へ引き渡すべきリードをAIが優先順位付けする。従来のルールベースのスコア(ポイント加算式)を、受注実績から学習するモデルへ置き換える。
必要なデータ条件: シングルパーソン(4-2)——重複があればスコアは分散し、このユースケースは成立しない。静的×動的データの統合(4-3)。学習には過去の受注・失注の結果データが必要で、実務上はDWHでの統合(第5章・第二段階)が前提になる。
実装の要点: スコアの閾値と引き渡しルールは、マーケと営業が合同で決める(第7章のSLAに接続)。スコアが「なぜ高いのか」の根拠(直近の行動、属性の適合)を営業画面に併記し、営業が納得して動ける状態を作る。
落とし穴: 根拠を示さないスコアは信用されず、使われない。また、学習データが偏っていれば——たとえば基幹由来の取引データに引きずられていれば(汚染源①)——スコアは過去の営業活動の癖を再生産するだけになる。
ユースケース④ ICP分析とターゲットリスト生成
概要: 受注・継続顧客の共通属性をAIが分析して理想顧客像(ICP)を抽出し、外部企業データベースと突合して、未接触のターゲット企業リストを生成する。
必要なデータ条件: 法人番号による企業の名寄せ(4-1)と静的データのエンリッチメント(4-3)。受注データとの結合(第5章・第三段階が理想、最低でも受注企業リストの突合)。
実装の要点: 分析対象は「受注」だけでなく「受注後に継続・拡大した顧客」に置く。売りやすい顧客と、良い顧客は違う。抽出したICPは第2章の全体図・第7章の目標設計に反映し、マーケと営業が同じターゲット定義を持つ状態を作る。
落とし穴: 名寄せ前の実行。企業が分裂したデータでは、AIが導く「優良顧客の特徴」は請求単位の断片の特徴になる(第3章)。
ユースケース⑤ 役割別コンテンツのパーソナライズ生成
概要: ナーチャリングメール、提案書の骨子、フォロー資料を、受け手の役割(着火役/旗振り役/番人/金庫番)とフェーズに応じてAIが生成・出し分ける。
必要なデータ条件: ユニットと役割の構造化(4-4)。役割別に何を訴求すべきかの定義(第1章の調査ファクト——意思決定者は信頼性、影響者は品質——が初期の設計指針になる)。
実装の要点: 全文自動生成ではなく、「役割×フェーズ別の訴求フレーム」を人が設計し、AIには個別文脈への適合(相手企業の業界、直近の接点への言及)を担わせる。生成の品質は、フレームの品質で決まる。
落とし穴: 役割データの精度が低い段階で全面展開すること。番人に投資対効果を、金庫番に技術仕様を送る誤配は、パーソナライズしない場合より信頼を損なう。役割の確度が高い相手から段階的に広げる。
ユースケース⑥ 商談準備ブリーフの自動生成
概要: 商談前に、対象企業の統合情報——企業属性、ユニット内の関与者と役割、これまでの全接点履歴、進行中の他案件、直近の行動シグナル——をAIが1枚のブリーフに要約し、営業に届ける。
必要なデータ条件: 6例の中で最も重い。企業・パーソンの名寄せ、静的×動的統合、ユニット構造、そしてDWHでの横断統合(第5章)——本書の整備のほぼ全体を前提とする。
実装の要点: その分、効果は営業体験の中核に届く。属人化していた「準備の質」が組織標準になり、担当交代時の引き継ぎコストが消える。第1章の「営業が感知する前に案件が進む」状況への直接の対抗策——会う前に、買い手の検討状況を売り手も把握して臨む——である。
落とし穴: 情報の網羅を優先し、ブリーフが長文化すること。営業が商談5分前に読める分量(1画面)に要約の焦点を絞る。
6-3. 実装の共通原則
6例を貫く原則を三つにまとめる。
第一に、精度が出ないときは、AIではなくデータを疑う。 各ユースケースの「必要なデータ条件」は、そのまま障害切り分けのチェックリストである。スコアが当たらないなら名寄せを、ICPが的外れなら汚染源①を、パーソナライズが誤配するなら役割データを確認する。モデルやツールの乗り換えは、データ条件の確認が済んでからでよい。
第二に、AIはドラフトと示唆、人は判断と関係構築。 本章の6例はいずれも、AIが下書き・要約・優先順位・警告を出し、人が確定・実行する設計である。この分担は品質管理であると同時に、第2章で述べた営業リソースの再配分——作業をAIへ移し、営業を営業にしかできない仕事へ集中させる——の実装でもある。
第三に、ユースケースは追加するほど安くなる。 6例はすべて同じ土台(シングルレコード、静的×動的、ユニット、DWH)の上で動く。①で商談データが整い、②③でリードが循環し、④⑤⑥がその上に載る——各ユースケースの出力が次のユースケースの入力になる。第2章で述べた「一度整えれば、すべてに効く」の具体的な姿である。
ただし、この循環には維持の仕組みが要る。データの品質も、AIの出力品質も、放置すれば劣化する。次章では、整えた環境を維持し続けるための組織とガバナンスを扱う。

