
第3章 AIの精度を壊す「よくある汚染源」
3-1. なぜ汚染源から話すのか
前章で述べた通り、データ整備の起点は基盤の構築ではなく、汚染の発生源の特定である。本章はその作業にあたる。
前提として押さえておきたいのは、AIがデータを扱う際の性質である。AIは与えられたデータをそのまま事実として扱い、判断する。重複・欠落・陳腐化を検知して自ら補正することはない。同一人物が3つのレコードに分かれていれば3人の別人として扱い、退職者のレコードが残っていれば現役の見込み客として扱う。データの誤りは、そのままAIの判断の誤りになる。
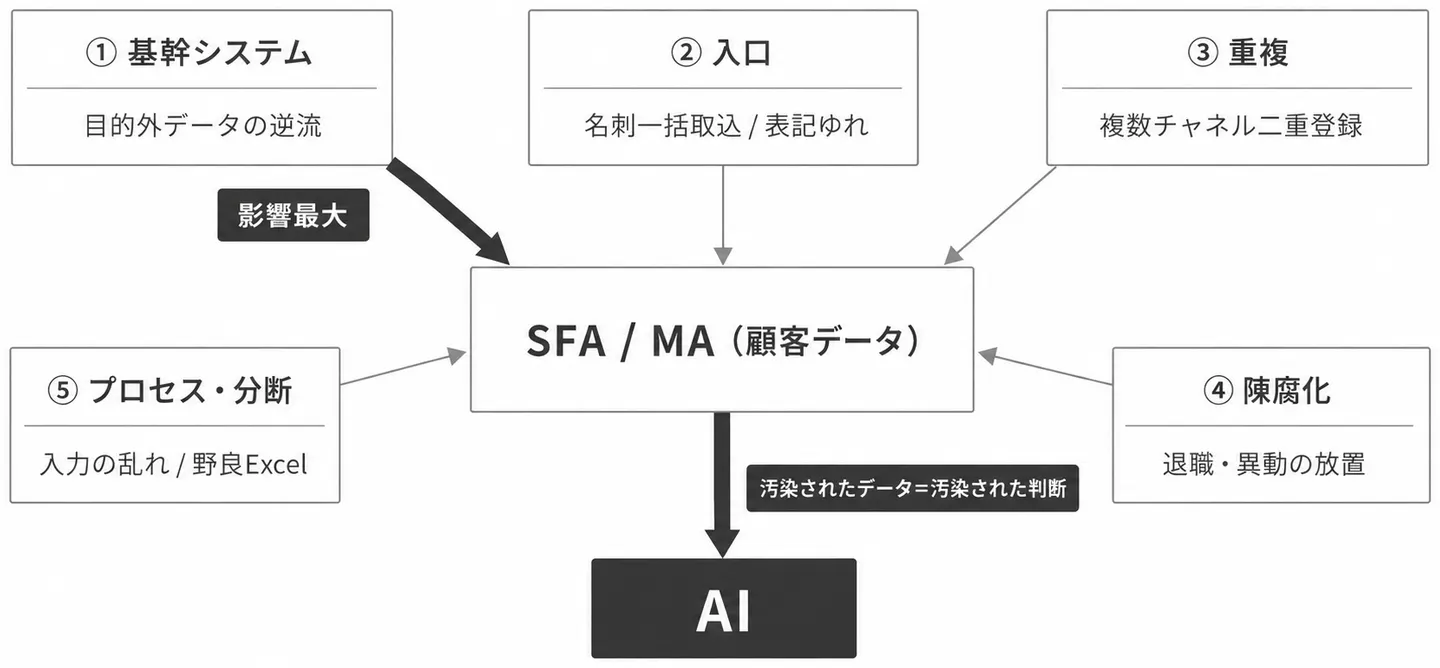
本章では、どの業務プロセスから、どのような汚染データが発生するのかを、影響の大きい順に五つ整理する。五つの発生源の全体像を図3-1に示す。自社に当てはまるものを特定しながら読み進めてほしい。第4章で述べる対策は、ここで特定した発生源と一対一で対応する。
3-2. 汚染源① 基幹システムからのデータ流入
最初に取り上げるのは、影響が最も大きく、かつ善意から発生する汚染源である。基幹システム(ERP・販売管理システム)からSFAへのデータ連携だ。
典型的な経緯はこうである。SFA導入時、顧客データをゼロから入力する手間を省くため、「基幹システムが全社のマスタなのだから」という判断で、基幹の取引先データを一括でSFAに流し込む。以後も基幹を正として、定期連携で上書きを続ける。一見、合理的な設計に見える。
しかし、この連携はデータが本来流れるべき方向と逆である。本来の流れは、営業・マーケティング活動で得た顧客情報が商談を経て受注に至り、その取引データが基幹システムに登録される、という順である。基幹システムは受注以降の取引を記録する下流のシステムであり、そこに蓄積されているのは請求先・支払条件・取引実績である。営業・マーケティングが必要とする情報——部署、担当者、役職、検討状況、接点履歴——は、基幹には最初から存在しない。
目的の異なるデータを顧客管理の起点に据えると、SFA上で次の症状が発生する。
- 企業レコードの分裂。 基幹の取引先コードは請求単位で採番されているため、同じ会社が「支払サイト別」「事業所別」「取引部門別」に複数レコードとして流入する。1社の取引先が10以上のレコードに分かれている例は珍しくない
- 中身のないアカウントの大量発生。 担当者情報を持たない、請求先住所しかない企業レコードがSFAを埋める。営業から見れば「使えないデータの山」であり、SFAへの入力意欲そのものを削ぐ
- 正しい修正の消失。 営業がSFA上で企業情報を修正しても、次の定期連携で基幹のデータに上書きされて戻る。現場は修正を諦め、SFAの情報は誰も信じなくなる
AIへの影響は深刻である。企業が分裂していればアカウント単位の分析は成立せず、ICP分析(勝ちパターンの顧客像抽出)は請求データの偏りに引きずられる。取引実績しか持たないレコード群を学習すれば、AIが導く「優良顧客の特徴」は「支払条件の特徴」になる。
誤解のないよう付け加えるが、基幹システムのデータが悪いのではない。請求・取引管理という本来の目的においては正確なデータである。問題は、目的の異なるシステムへ、方向を誤って流し込む連携設計にある。基幹は取引のマスタ、SFAは顧客関係のマスタ——マスタは全社で一つではなく、目的別に定義するものである。この整理は第4章で詳述する。
3-3. 汚染源②〜⑤ 業務プロセスから日常的に発生する汚染
基幹連携が構造的・一括的な汚染だとすれば、以下の四つは日常業務から少しずつ、しかし止まることなく発生する汚染である。
汚染源② 入口の汚染——データが生まれる瞬間の品質不良。 展示会で回収した名刺の一括取込は、その典型である。役職・部署の表記が名刺ごとにバラバラなまま、時には数千件単位で流入する。Webフォームの自由入力欄も同様で、会社名は「株式会社」「(株)」「㈱」、全角と半角、法人格の前後が入り混じる。この表記ゆれは後続のすべての処理——名寄せ、重複判定、企業マッチング——の精度を下げる。入口で汚れたデータは、下流の工程すべてでコストを発生させる。
汚染源③ 重複の汚染——同一人物・同一企業の分裂。 同じ人物が、展示会経由・Web資料請求経由・セミナー申込経由でそれぞれリード登録され、別人として存在する。MAとSFAの双方に登録され、二重にカウントされる。重複の実害は数の水増しにとどまらない。行動履歴が複数レコードに分散するため、本来なら高スコアで営業へ渡るべき見込み客が、どのレコードでも閾値に達しない。熱量の高い買い手ほど接点が多く、接点が多いほど重複が生まれやすい——つまり重複は、最も確度の高いリードから順に見えなくするという性質を持つ。
汚染源④ 陳腐化の汚染——放置による鮮度の喪失。 人は異動し、転職し、会社は社名変更や統合を重ねる。多くの組織には、これを反映する更新のプロセスがない。退職者への配信を続ければメールの到達率が下がり、ドメイン全体の評価が落ち、現役の見込み客にもメールが届かなくなる。AIが陳腐化データを学習すれば、既に存在しない部署の、既に転職した人物へのアプローチを「有望」と提案する。
汚染源⑤ プロセスと分断の汚染——運用が生む汚染。 営業の入力漏れ・自己流入力はその代表である。商談の経緯がSFAに記録されない、あるいは「進行中」の定義が営業ごとに違う。第1章で見た通り、リードステージの定義スコアは2.23——「名称はあるが運用は曖昧」が業界の平均像であり、同じ「商談化」という言葉が部門や個人によって別の状態を指す。さらに、SFAに載らない情報が部門ごとのExcel・スプレッドシートに分散して管理される。そこにあるデータは本人以外に存在すら知られず、更新されず、全社のデータ資産から切り離されている。定義が揃わず、記録が分散している状態は、AIから見れば「学習すべき正解が存在しない」状態である。
3-4. 汚染がAIに与える実害——対応表と点検リスト
五つの汚染源とAI出力への実害を対応させる。
| 汚染源 | 発生箇所 | AIへの実害(例) |
|---|---|---|
| ①基幹システム流入 | システム連携設計 | 企業分裂によりアカウント分析が不成立/ICP分析が取引データに歪む |
| ②入口の汚染 | 名刺取込・フォーム | 名寄せ・企業マッチング精度の低下/セグメント配信の誤爆 |
| ③重複 | 複数チャネル登録 | スコアの分散により有望リードほど検知されない/リード数・CVの過大計上 |
| ④陳腐化 | 更新プロセスの不在 | 退職者への自動送信/到達率悪化による配信基盤全体の毀損/実在しない相手への提案 |
| ⑤プロセス・分断 | 入力運用・野良管理 | 学習データの欠損と定義不一致/商談要約・売上予測の前提崩壊 |
最後に、自社の汚染度を点検する10項目を挙げる。3つ以上該当すれば、AI活用の前にデータ整備を優先すべき状態である。
- 基幹システムの取引先データを、SFAへ定期連携で流し込んでいる
- SFA上に、同一企業が複数レコードで存在する
- 担当者が1人も紐づいていない企業レコードが大量にある
- 展示会の名刺を、整形せずに一括登録している
- 同一人物が、MAとSFAに別々に登録されている
- 過去1年、退職・異動を理由としたデータ更新を組織的に行っていない
- 配信メールの到達率・エラー率を誰も把握していない
- 「商談化」「有効リード」の定義を、営業とマーケで即答できる人がいない
- SFAに入力されない顧客情報が、個人のExcel・メモに存在する
- 営業がSFAの顧客情報を「信用していない」と感じる場面がある
これらの汚染源は、根性論やルールの通達では止まらない。発生源ごとに、仕組みで遮断する必要がある。次章では、その中核となるデータ基盤の設計——シングルパーソン/シングルアカウント——を解説する。

