
第4章 データ基盤の正しい設計——シングルパーソン/シングルアカウント
4-1. 核となる思想:1人の人物は1レコード、1つの企業は1レコード
前章で特定した汚染源への対策は、個別のクレンジング作業の積み重ねではない。まず、データをどのような形で持つべきかという設計思想を定める。本書が提示する原則は、次の一文に尽きる。
1人の人物は1レコード、1つの企業は1レコードで管理する。 本書ではこれをシングルパーソン/シングルアカウントと呼ぶ。
単純に聞こえるが、前章の点検リストに3つ以上該当した組織で、この状態が成立していることはまずない。同一人物が流入経路ごとに複数のリードとして存在し、同一企業が基幹由来のコード体系で分裂している——それが平均像である。
なぜこの原則が土台になるのか。AIの側から考えると明確である。AIが「この見込み客は有望か」を判断するには、その人物に関するすべての情報——所属、役職、Web行動、メール反応、過去の商談——が1つのレコードに集約されている必要がある。情報が3つのレコードに分散していれば、AIは3人の別人をそれぞれ「情報の乏しい低スコアのリード」と評価する。第3章で見た通り、重複は最も確度の高いリードから順に見えなくする。シングルパーソン/シングルアカウントとは、AIに渡す判断材料の最小単位を正しく定めることである。
マスタは全社で一つではなく、目的別に定義する
この原則を実装する際、必ず突き当たるのが「では、どのシステムをマスタにするのか」という問いである。第3章の汚染源①は、この問いに「基幹システム」と短絡的に答えた結果だった。
正しい整理はこうである。マスタとは「その目的において正とするデータの置き場所」であり、目的が違えばマスタも違う。
- 取引のマスタは基幹システム。 請求先、支払条件、取引実績——受注以降の事実は基幹が正である
- 顧客関係のマスタはSFA(またはDWH)。 企業の実体、組織構造、担当者、検討状況、接点履歴——受注に至るまでの関係の事実はこちらが正である
両者は接続するが、方向と範囲を限定する。顧客関係のマスタ側で「実在する企業」を法人単位で定義し、基幹の取引先コードはその企業レコードに子として紐づける(1つの企業に複数の取引先コードがぶら下がる構造)。基幹からSFAへ流すのは取引実績などの参照情報に限定し、企業の名称・住所・組織情報を上書きさせない。これで汚染源①は構造的に遮断される。
いわゆるSSOT(Single Source of Truth)とは、全データを一つのシステムに入れることではない。項目ごとに「どこが正か」が一意に定まっており、矛盾したときにどちらを信じるかを誰も迷わない状態を指す。
4-2. シングル化を実現する手順
原則を運用に落とす。作業は「企業の名寄せ」「人の名寄せ」「維持の自動化」の三段階である。
企業(アカウント)の名寄せ:法人番号を軸にする
企業の名寄せで最初に決めるべきは、企業を一意に識別するキーである。社名は表記ゆれと変更があり、キーにならない。日本国内の企業であれば、答えは法人番号である。国税庁が全法人に付番する13桁の番号は、無償で公開されており、社名変更や本店移転を追跡できる唯一の公的キーだ。
手順は次の通りである。
- 既存の全企業レコードに法人番号を付与する。 社名・住所から法人番号を照合するマッチング処理を行う(外部のデータサービスやマッチングツールを利用するのが現実的である)
- 同一法人番号のレコードを統合する。 ここで前章の「基幹コード由来の分裂」「表記ゆれによる分裂」が一括で解消される
- 企業の階層を設計する。 親会社—子会社、本社—事業所をどう扱うかを決める。営業・マーケティングの実務では「商流の単位」(どこと契約するか)と「アプローチの単位」(どの事業所の誰に会うか)がずれることがあるため、法人を親、事業所を子とする階層で持ち、集計時にどちらでも切れる構造にしておく
人(パーソン)の名寄せ:キーの優先順位を定める
人には法人番号にあたる公的キーがない。したがって、複数の属性を組み合わせた判定ルールを自社で定義する。実務上の優先順位は次が標準である。
- ビジネスメールアドレスの完全一致——最も信頼できるキー。同一アドレスは同一人物とみなす
- 氏名×所属企業(法人番号)の一致——アドレスが異なる場合の第二判定。同姓同名リスクがあるため、部署・役職の整合を補助条件にする
- あいまい一致は自動統合しない——氏名の表記ゆれ(漢字/カナ)や旧姓変更などは候補として抽出し、人が確認して統合する
あわせて、統合時の生存ルール(サバイバーシップ)を決めておく。2つのレコードを統合するとき、役職はどちらを残すか。原則は「項目ごとに、更新日時が新しい方を残す。ただし手入力よりも本人申告(フォーム入力)を優先する」——このルールを明文化しておかないと、統合のたびに判断がぶれ、統合作業そのものが新しい汚染になる。
維持の自動化:名寄せは一度きりの作業ではない
初期の名寄せで既存データを整えても、翌日から新しいリードが流入する。シングル状態を維持する仕組みを、流入経路に組み込む。
- 入口での正規化:フォーム・名刺取込の時点で、会社名の表記を統一し、法人番号を自動付与する(汚染源②の遮断)
- 登録時の重複判定:新規リード登録時にメールアドレス・氏名×企業で既存レコードを自動照合し、一致すれば新規作成ではなく既存への追記とする(汚染源③の遮断)
- 定期的な棚卸し:メール到達エラー(ハードバウンス)を退職・異動のシグナルとして検知し、確認・更新のワークフローに乗せる。四半期に一度、名寄せ候補と長期未更新レコードをレビューする(汚染源④の遮断)
4-3. データを「リッチ」にする2つの付加要素
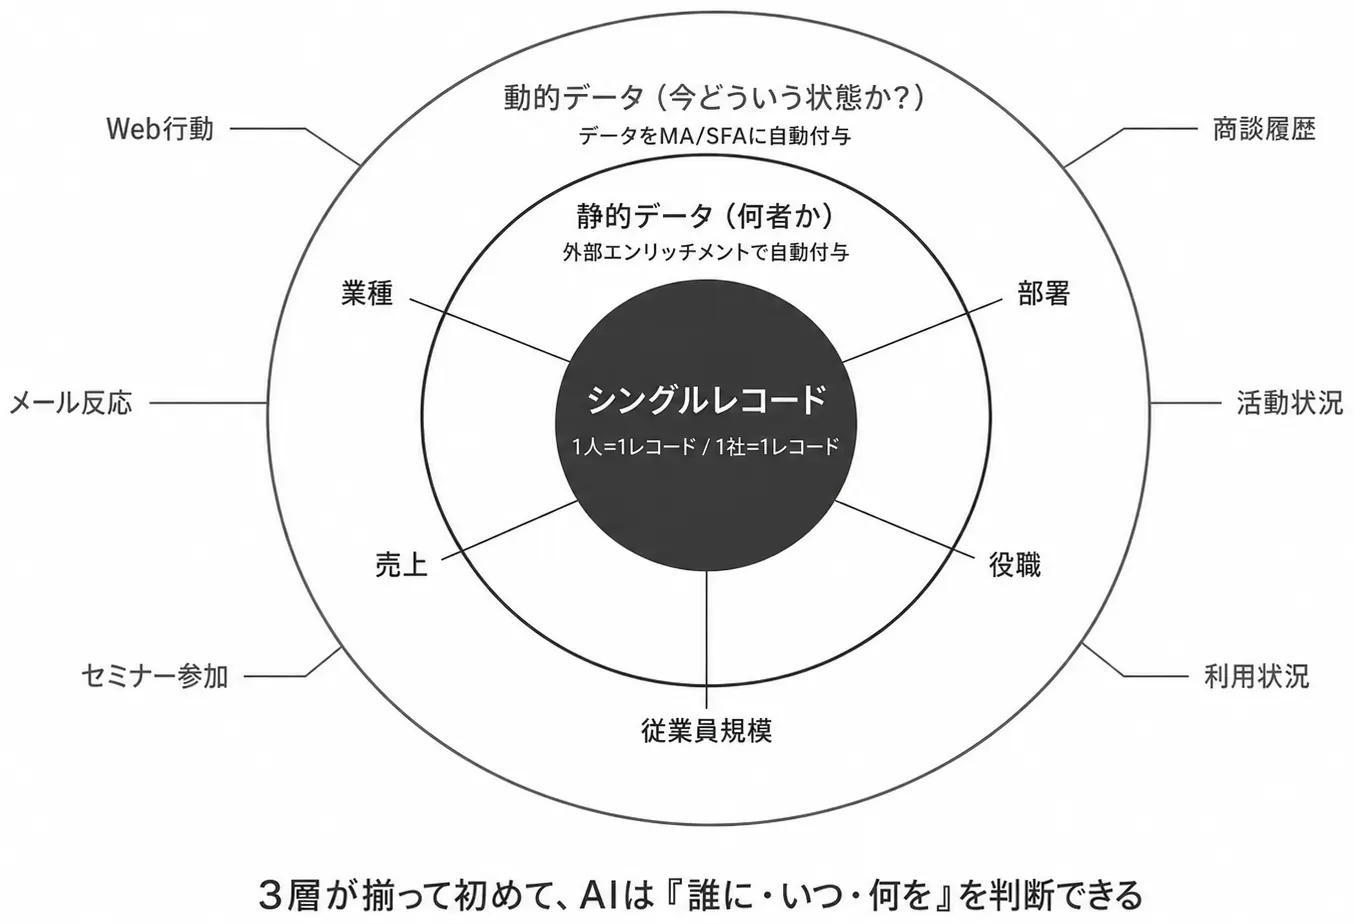
シングル化は土台であり、それ自体はまだ「重複のない住所録」にすぎない。AIが判断材料として使える状態にするには、1つに定まったレコードへ情報を付加していく。付加する情報は、性質の異なる2種類に分けて設計する。
静的データ:その企業・人物が「何者か」を示す属性
企業側の静的データは、業種、従業員規模、売上規模、資本系列、上場区分など。人側は、部署、役職、職種である。これらは変化が緩やかで、セグメンテーションとターゲティングの軸になる。
重要なのは、静的データは自社で集めるものではないという割り切りである。業種や従業員規模をフォームで買い手に入力させるのは、買い手に負担を転嫁しているだけであり、入力の質も揃わない。法人番号をキーに外部の企業データベースと接続すれば、これらの属性は自動で付与・更新できる(エンリッチメント)。4-2で法人番号を軸に据えた理由の一つは、この外部接続の鍵になるからである。フォームで買い手に尋ねるのは、外部から取得できない情報——検討状況、課題、導入時期——に絞る。
動的データ:その人物が「今、どういう状態か」を示す行動・時系列情報
Webページの閲覧、メールの開封・クリック、セミナー・展示会への参加、資料のダウンロード、商談の履歴、そして受注後の利用状況。これらは日々変化し、鮮度が価値である。
静的データと動的データは、答える問いが違う。静的データは「この相手は狙うべき相手か(ターゲットとしての適合度)」に答え、動的データは「この相手は今、動くべき相手か(タイミングと熱量)」に答える。第1章で見た通り、買い手の検討は営業の見えない場所で進む——その見えない検討を売り手側で捉える唯一の手がかりが、動的データである。
そしてAIの判断は、この2つの掛け合わせで初めて成立する。「製造業・従業員1,000名超・製造部門の部長職(静的)が、この2週間で価格ページを3回閲覧し、事例資料をダウンロードした(動的)」——ここまで揃って、AIは「誰に・いつ・何を」を根拠を持って提案できる。静的データだけならただのリスト、動的データだけなら誰のものか分からない行動ログである。
4-4. アカウントとパーソンを紐付け、購買グループを捉える
「1社1担当者」のデータ構造が、受注を遠ざける
第1章で確認した事実に立ち返る。高価格帯の購買には平均18.3人が関与し、一人の担当者が関与するフェーズも広がっている。そして役割によって見ているものが違う——意思決定者は会社の信頼性を、意思影響者は製品の品質と技術的裏付けを評価する。
ところが多くのSFAのデータ構造は、この実態を記録できない。案件には「先方担当者」が1人紐づくだけで、その背後にいる関与者たち——検討を言い出した人、社内を動かしている人、リスクを審査する人、予算を握る人——は、営業個人の頭の中にしか存在しない。担当者が異動すれば、案件の人間関係の地図は組織から消える。属人化の最も深刻な形は、ここにある。
購買グループを4つの役割で構造化する
当社は購買グループの関与者を、機能に着目して4つの役割で捉えている(RRF:レベニュー・ロール・ファインダー)。
- 着火役——課題を最初に認識し、検討を始動させる人。現場で問題に直面している実務者であることが多い
- 旗振り役——社内の合意形成を主導し、検討を前に進める推進者。売り手にとって最も重要な社内の代弁者
- 番人——リスクを審査する人。情報システム、法務、品質保証など、要件を満たさなければ検討を止める権限を持つ
- 金庫番——予算と最終決裁を握る人。製品の優劣ではなく、投資の妥当性と会社としての信頼性を判断する
重要なのは、これが「役職」ではなく「役割」だという点である。同じ部長職でも案件によって旗振り役にも番人にもなる。だからこそ、名刺情報(静的データ)だけでは役割は分からず、行動(動的データ)と商談での観察から推定して記録する必要がある。
「1社」の中に、購買グループは複数ある
ここまで「案件に関与する複数人を束ねる」と述べてきたが、実務ではさらに一歩進んだ認識が必要になる。1つの企業の中に、購買グループは複数、同時に存在する。
これは二つの方向から発生する。
買い手が大きいほど、攻める対象は増える。 大企業では、事業部・拠点・子会社がそれぞれ独立した検討主体として動く。ある事業部で失注した商材が、別の事業部では検討すらされていない——つまり1社の中に、フェーズも温度もまったく異なる複数の商機が併存する。「この企業とは取引済み/失注済み」という企業単位のステータス管理は、この構造の前で意味を失う。
売り手の事業が増えるほど、同じ企業への入口は分かれる。 複数のサービスラインを持つ売り手にとって、同じ企業でもサービスAの買い手とサービスBの買い手は別の部門・別の人々である。当然、購買グループの構成——誰が着火し、誰が審査し、誰が決めるか——もサービスごとに変わる。事業を拡張してきた企業ほど、「同じ会社に、違う商材で、違うグループへ」という多面的なアプローチが必要になる。
したがって、購買グループとは「企業」でも「案件の関係者リスト」でもなく、企業の内部にある検討のユニットである。問題は、そのユニットの境界をどう引くかだ。
ユニットの境界は、組織図ではなくデータから発見する
素朴な答えは「部門で区切る」だが、これだけでは足りない。組織図上の部門と、実際に一緒に検討している集団は、一致するとは限らない。部門横断のプロジェクトもあれば、同じ部門でも拠点ごとに別々に動くこともある。
正しいアプローチは、静的な構造と動的なシグナルの両面からユニットを推定することである。
- 静的な手がかり:拠点(事業所)、部門、子会社——4-1で設計した企業・部門の階層構造がここで効く。同じ拠点・同じ部門への所属は、同一ユニットの第一次推定になる
- 動的な手がかり:行動の同一性である。同じ企業の複数の人物が、同じ時期に、同じテーマのコンテンツに接触している——同一の資料をダウンロードし、同じウェビナーに参加し、同じ製品ページを閲覧している。この行動の同期は、組織図には現れない「いま一緒に検討している集団」の存在を示す最も強いシグナルだ
つまり、ユニットの認定は「部門が同じだから」でも「誰かがそう言ったから」でもなく、データが同一性を示しているから行うものである。そしてこの推定は、シングルパーソン/シングルアカウント(4-1、4-2)と静的×動的データ(4-3)が整っていて初めて可能になる。人物が重複していれば行動の同期は検出できず、部門情報が欠落していれば静的な手がかりがない。本章で積み上げてきた設計は、すべてこのユニット検出の前提条件だったと言ってよい。
業界が変われば、ユニットの分かれ方も変わる
例1:半導体・電子部品(製造業の設計採用)。 買い手が大手電機メーカーであれば、事業部ごと・製品ラインごとに設計チームが存在し、それぞれが独立したデザインイン検討のユニットになる。A事業部で採用された部品が、B事業部では競合品と比較の最中——ということが同一企業内で並行する。着火役は各ユニットの設計エンジニアであり、初期の動的データ(技術資料の閲覧、評価サンプル請求)はユニットごとに発生する。一方で品質保証や購買といった番人・金庫番の機能は全社共通のことも多く、ユニット固有の関与者と全社横断の関与者が混在する。この構造を捉えられれば、「A事業部での採用実績」を武器にB事業部のユニットへ横展開する、という打ち手がデータから設計できる。
例2:旅行・MICE(サービス業の法人利用)。 同じ企業が、周年イベントは経営企画、報奨旅行は人事、学会運営は事業部門と、案件の性質ごとに別のユニットで発注する。窓口はいずれも総務が担うため、企業単位・窓口単位で見ると「同じ顧客」に見えるが、実際には目的も予算も決裁者も異なる別々の購買グループである。ユニットを区別せずに接点履歴を混ぜると、「この会社は毎年発注してくれる」という誤った全体像が生まれ、実際には人事ルートの関係しか築けていないことに気づけない。
データ構造への実装:企業→部門→人→ユニット→案件関与
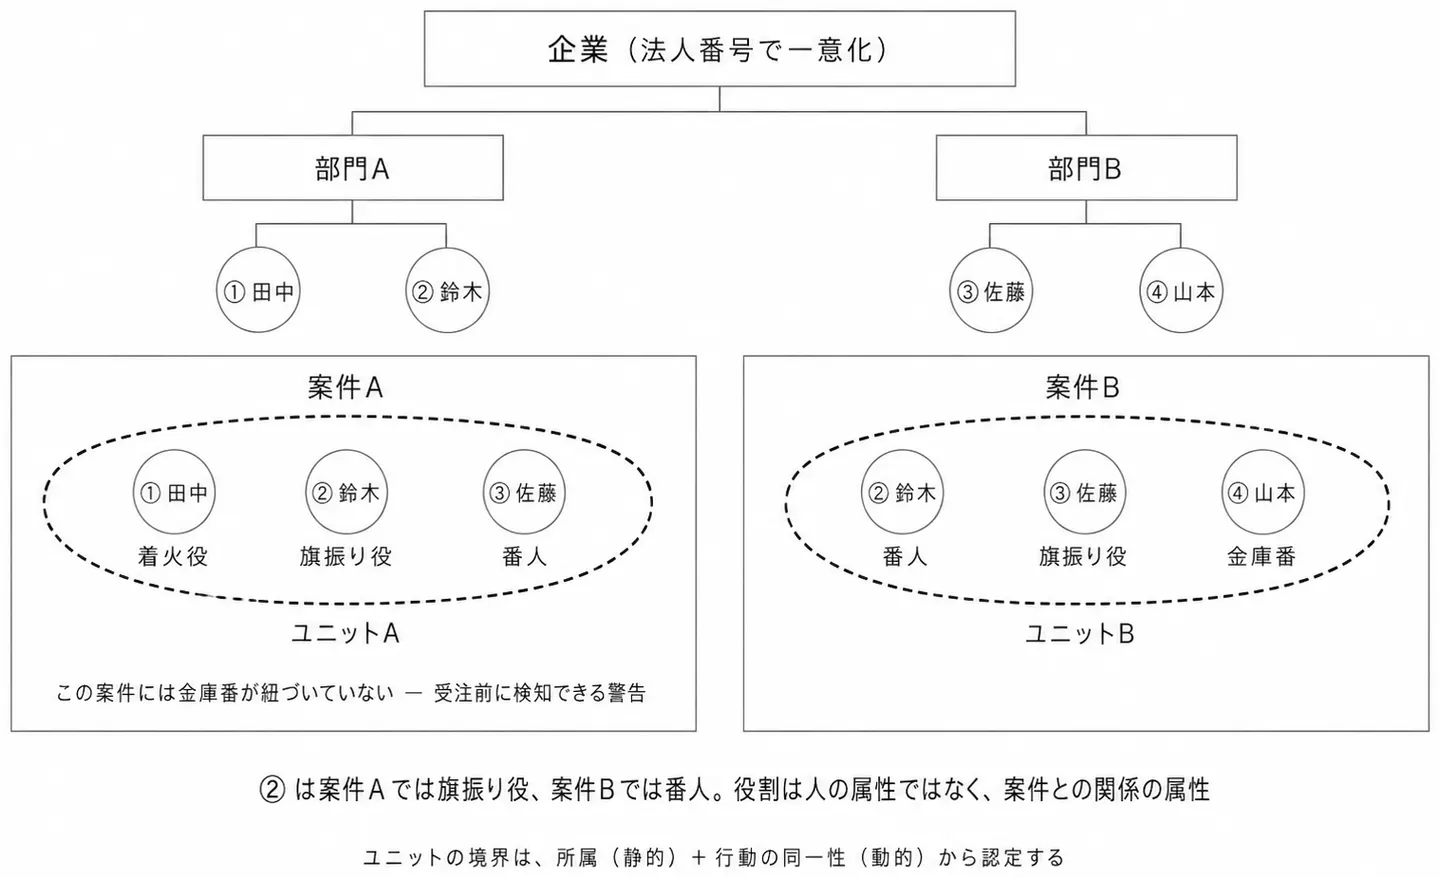
以上を踏まえ、データ構造は次の階層で設計する。この階層構造を図4-2に示す。
- 企業(アカウント)——法人番号で一意化(4-1)
- 部門・拠点——企業の子レコード。パーソンの所属先
- 人(パーソン)——名寄せ済み、静的×動的データ付き(4-2、4-3)
- 購買グループ(ユニット)——検討の単位。所属(静的)と行動の同期(動的)から認定し、パーソンを多対多で紐づける
- 案件への関与——ユニット内の各パーソンに、役割(着火役/旗振り役/番人/金庫番)と関与フェーズを属性として持たせる
ポイントは、役割を人の属性として書き込まないことである。同じ人物が、案件Aでは旗振り役、案件Bでは番人になり得る。役割は人の属性ではなく、案件との関係の属性である。同様に、ユニットも固定的な組織ではなく検討ごとに生まれる動的な集団である。データ構造は、この流動性を許容する形(多対多の紐付け)で設計する。
この構造が可能にすること
ユニット単位の熱量把握。 担当者個人ではなく「この企業のこのユニットから、この1ヶ月で何人が、どのコンテンツに接触しているか」を捉える。1人の3回の訪問より、3部門の3人の初訪問の方が、新しいユニットの発生——組織的な検討開始——のシグナルとして強い。半導体の例でいえば、設計者に続いて品質保証部門のアクセスが現れた時点で、検討はフェーズを進めたと推定できる。
関与者の欠落検知。 案件に金庫番に相当する人物が一人も紐づいていない——これは受注前に検知できる最も価値ある警告である。第1章で見た通り、意思決定者が最も重視するのは会社の信頼性であり、金庫番と接点がないまま提案評価に進んだ案件は、技術評価で勝っても最後の一段で落ちる。
役割別の情報の出し分け。 着火役・旗振り役には課題解決と社内説得の材料を、番人には要件適合の証明を、金庫番には投資対効果と会社の信頼性を。第1章の「役割によって見ているものが違う」への、データ構造上の回答である。
そしてAIの学習対象になる。 受注案件と失注案件の関与構造——何人が、どの役割で、どのフェーズから関与していたか——が蓄積されれば、AIは「この案件は関与構造が受注パターンに近いか」を判定できるようになる。個人単位のスコアリングでは決して到達できない、案件単位の確度予測である。
ここまでが、データの持ち方の設計である。シングルパーソン/シングルアカウントで単位を定め、静的×動的で厚みを持たせ、ユニットの構造で購買グループを捉える。次章では、この設計をどこに実装するか——MA/SFAの中で完結させるべきか、DWHに進むべきか——というアーキテクチャの判断を扱う。

