
第5章 MA/SFAからDWHへ——アーキテクチャの分水嶺
5-1. MA/SFAは「業務アプリケーション」であり、「データ基盤」ではない
第4章で設計したデータの持ち方を、どこに実装するか。多くの企業の暗黙の答えは「MA/SFAの中で」である。すでに導入済みで、顧客データも入っている。ここに整えていけばよい——自然な発想に見える。
しかし、この発想には前提の誤りがある。MAとSFAは、それぞれ明確な業務目的を持つアプリケーションである。
- MAは、マーケティングの実行と管理のためのアプリケーション。 セグメントへの配信、シナリオの実行、スコアリング、フォームとLPの運用——マーケティング施策を回し、その結果を管理することに最適化されている
- SFAは、営業の実行と管理のためのアプリケーション。 商談の記録、活動の管理、パイプラインの進捗、売上予測——営業活動を回し、組織として管理することに最適化されている
つまり両者は「実行と管理」の道具であり、データの蓄積・結合・分析のために設計されたデータ基盤ではない。業務アプリケーションに求められるのは「現場が今日の業務を回せること」であり、データ基盤に求められるのは「あらゆるデータを、あらゆる切り口で、制約なく扱えること」である。この二つは設計思想が根本から異なる。
MA/SFAをデータ基盤として使い続けると、具体的には次の限界に突き当たる。
データ構造の制約。 MA/SFAのオブジェクト構造(リード、取引先、商談など)は、それぞれマーケティング業務・営業業務を回すために製品側が定義したものであり、自由な拡張には限界がある。第4章で述べた「ユニット」のような独自の概念や、案件×パーソン×役割の多対多構造を、標準機能の範囲で無理なく表現できる製品は少ない。カスタムオブジェクトを重ねる方法もあるが、複雑化した構造は運用と後続の分析の双方を圧迫する。
行動データの粒度・保持期間、そしてAPIの制約。 MAが記録するWeb行動やメール反応は、スコアリングと施策実行に必要な範囲に最適化されており、生データの保持期間には制限があることが多い。数年分の行動履歴を遡ってAIの学習データにする、といった用途には耐えない。さらに見落とされがちなのがAPI制限である。多くのMA/SFA製品は、外部からのデータ取得・書き込みに対して1日あたりのAPIコール数や取得件数の上限を設けている。日常の軽い連携では問題にならないが、全行動履歴の抽出、大量レコードの一括更新、AIとのリアルタイム連携といったデータ基盤的な使い方を始めた途端、この上限が壁になる。「データは中にあるのに、取り出せない・戻せない」——連携設計の失敗として最も頻繁に遭遇するパターンであり、アーキテクチャを検討する際は各製品のAPI制限値を最初に確認すべきである。
ツールを跨いだ結合ができない。 MAの行動データ、SFAの商談データ、基幹の取引実績、広告の接触データ、CSの利用データ——レベニューサイクルの全体像は、これらを重ね合わせて初めて見える。しかしMAはマーケティングの、SFAは営業のデータをそれぞれ扱う場であり、外部データとの自由な結合の場ではない。「マーケ施策が受注にどうつながったか」というごく基本的な問い——MAとSFAの継ぎ目にある問い——に答えるだけで、複数ツールからのCSVダウンロードと手作業の突合が始まる。
AIに渡す前の加工の自由度がない。 AIの精度は、データの前処理——結合、集計、特徴量の設計——で決まる部分が大きい。業務アプリケーションの中では、この加工の自由度が根本的に不足する。
念のため付け加えるが、これはMA/SFAの欠陥ではない。マーケティングの実行と管理、営業の実行と管理という本来の役割において、両者は引き続き中心的なツールである。問題は、役割の違うものに役割の違う仕事をさせていることにある。第3章の基幹システムと同じ構図——「そこにデータがあるから」という理由で、目的の異なるシステムに別の役割を負わせる——が、ここでも起きているのである。
5-2. 分水嶺——自社はどちら側にいるか
とはいえ、すべての企業に専用のデータ基盤(DWH:データウェアハウス)が必要なわけではない。MA/SFAの中で完結してよい企業と、DWHへ進むべき企業の間には分水嶺がある。早すぎるDWH投資は、使われない基盤と維持コストだけを残す。判断基準を示す。
MA/SFA完結でよい企業の条件:
- 接続すべきデータソースが実質2つ以内(MAとSFA)で、基幹や他ツールとの結合要件がない
- リード数が数千件規模で、行動データの量も限定的
- 分析要件が「ファネルの通過率」「施策別のリード数」など、単一ツール内で完結する定型レポートの範囲
- AI活用が、MA/SFA製品に組み込まれた標準AI機能(スコアリング、送信時刻最適化など)の範囲で足りる
DWHへ進むべきサイン:
- 経営や営業から来る問いが、単一ツールでは答えられなくなっている。「どの施策経由の顧客が、受注後も継続しているか」「事業部別のパイプラインと広告投資の対応関係は」——ツールを跨ぐ問いに、誰も即答できない
- レポート作成のたびに、複数ツールからCSVをダウンロードしてExcelで突合する作業が常態化している。この手作業は工数の問題であると同時に、突合のたびに定義が揺れるという品質の問題でもある
- 第4章の設計——法人番号による名寄せ、静的×動的データの統合、ユニットの検出——を実装しようとして、MA/SFAの構造では表現しきれないと分かった
- 独自のAI活用(自社データでのICP分析、案件確度予測、解約予兆など)に踏み出したいが、学習に足るデータを一箇所から取り出せない
判断の本質を一言でいえば、データを「使う」場所と「貯めて整える」場所を分ける必要が生じているかである。データソースが増え、問いが部門を跨ぎ、AI活用が製品標準機能の先へ進む——この三つのうち二つが当てはまるなら、分水嶺は越えている。
なお、この判断は企業規模と必ずしも一致しない。第1章で見た年商500億円の崖は、この整備を「意図して越えた企業」と「規模が大きくなっても越えていない企業」の断層でもあった。逆に、規模が小さくとも複数事業・複数ツールを持つ企業は、早い段階で分水嶺に到達する。
5-3. DWH型アーキテクチャの全体像
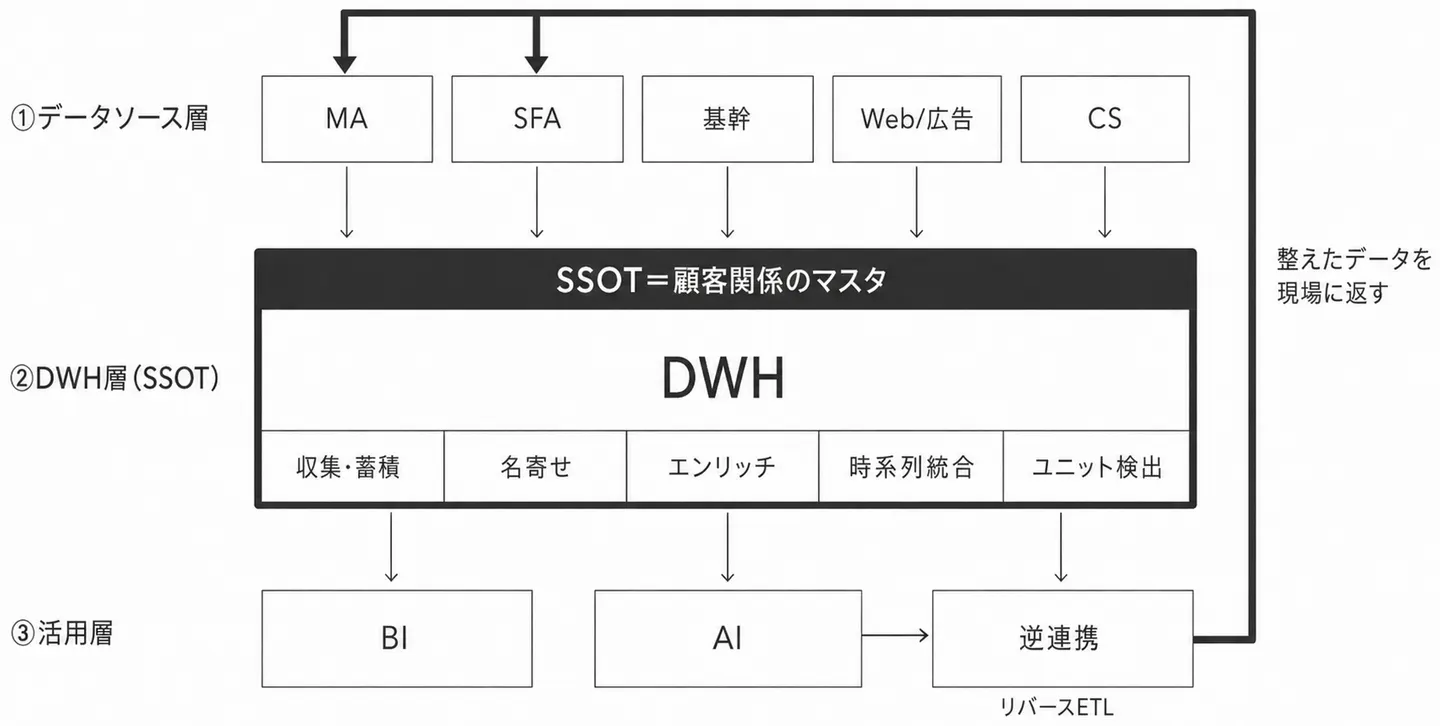
分水嶺を越えた企業が目指す構成を示す。全体は三つの層からなる。
① データソース層——データが生まれる場所。 MA、SFA、基幹システム、Webサイト、広告、CSツール、イベント管理。各システムは自身の業務目的のために動き続ける。ここに変更は加えない。
② DWH層——貯めて、整える場所。 各ソースからデータを収集・蓄積し、第4章の設計をここで実装する。法人番号による企業の名寄せ、パーソンの統合、静的データのエンリッチメント、動的データの時系列統合、そしてユニットの検出。SSOTの実体——「項目ごとにどこが正か」を定めた統合データ——が置かれるのは、この層である。クラウドDWH(BigQuery、Snowflakeなど)の普及により、この層の構築コストはかつてのDWH構築とは桁が違うほど下がっている。
③ 活用層——使う場所。 整ったデータの使い道は三つある。BIによる可視化(ダッシュボード、経営レポート)、AIによる分析・生成(スコアリング、確度予測、コンテンツ生成——第6章)、そして現場のツールへの逆連携である。
三つ目の逆連携(リバースETL)は、DWH型アーキテクチャの成否を分ける要素なので補足する。DWHで整えたデータ——名寄せ済みの企業情報、エンリッチした属性、AIが算出したスコア——を、MA/SFAに書き戻す仕組みである。これがないと、整ったデータは分析者だけのものになり、営業とマーケの日常業務は汚れたままのMA/SFAで回り続ける。営業がSFAの画面を開けば、そこに名寄せ済みの企業情報とAIの示唆が表示されている——現場から見れば「SFAが賢くなった」ように見える状態を作ることが、逆連携の目的である。データ基盤の価値は、基盤の中ではなく、現場の画面の上で発揮される。
役割分担の再定義
この構成により、各システムの役割は次のように整理される。第3章・第4章で述べた「マスタは目的別」の最終形である。
| システム | 役割 | 持つべきデータ |
|---|---|---|
| 基幹システム | 取引の記録 | 請求・支払・取引実績(取引のマスタ) |
| MA | マーケティングの実行と管理 | 配信・スコアの実行データ(実行の場) |
| SFA | 営業の実行と管理 | 商談・活動の記録(現場の作業場) |
| DWH | 統合と真実 | 名寄せ済みの顧客・行動・取引の統合データ(顧客関係のマスタ=SSOT) |
| BI/AI | 判断の支援 | DWHから生成される可視化と予測 |
汚染源①(基幹→SFAの直結)がなぜ誤りだったかも、この表で最終的に説明がつく。基幹とSFAは本来直接つなぐ関係ではなく、DWHを介して「取引の事実」と「関係の事実」を突合させる関係である。
スモールスタートの現実解
最後に、移行の順序である。三層の全体像を最初からすべて作ろうとしてはいけない。全ソース接続・全項目統合を狙った基盤構築プロジェクトは、要件定義が肥大化し、価値を出す前に失速する。
現実的な起点は次の三段階である。
- 第一段階:企業マスタの統合から。 MA/SFAの企業データをDWHに集め、法人番号で名寄せし、外部データで属性を付与する。対象を「企業」に絞ることで、最初の成果(重複のない、属性の揃った企業リスト)を数ヶ月で出す
- 第二段階:パーソンと行動の統合。 人の名寄せと、MAの行動データ・SFAの活動データの時系列統合。ユニット検出と第6章のAIユースケースの多くは、ここまでで動き始める
- 第三段階:基幹・CS・広告への拡張。 取引実績と利用データを加え、レベニューサイクル全体——受注後まで含めた循環——をデータで再現する
各段階で、逆連携によって現場に価値を返すことを忘れてはならない。第一段階の名寄せ済み企業データをSFAに書き戻すだけでも、営業の体感は変わる。基盤プロジェクトが失速する最大の理由は技術ではなく、「現場が価値を感じる前に、経営が投資に疲れる」ことである。段階ごとに現場の画面に成果を届ける設計が、投資を継続させる。
データの持ち方(第4章)と置き場所(本章)が定まった。次章では、この土台の上で何を動かすか——生成AI活用の実装に進む。

