第2章 レベニューサイクルとは何か
2-1. ファネルの限界
BtoBの売上創出プロセスは、長らく「ファネル」で説明されてきた。マーケティングがリードを獲得し、インサイドセールスが選別し、営業が商談・受注する——上から下へ一方向に流れる漏斗のモデルである。
このモデルには、構造的な欠陥が三つある。
第一に、一方通行であること。ファネルの各段階で脱落したリード——失注した案件、返信のなかった見込み客、時期尚早だった検討者——は、プロセスの外に捨て置かれる。だが第1章で見た通り、買い手の検討は売り手の見えない場所で続いている。今日失注した相手が、半年後に再び検討を始めることは珍しくない。実際、当社の購買プロセス調査では、高価格帯の買い手の17.8%が検討に半年以上をかけていた。ファネルから脱落した時点でフォローが途絶える設計は、この長い検討期間と噛み合わない。
第二に、部門ごとの分断を前提としていること。マーケティングはリード獲得数、インサイドセールスは商談化数、営業は受注額と、各部門が自部門の指標だけを最適化する。第1章で確認した「目標共有」スコア2.31——マーケティングと営業が同じ売上目標を持てていない実態——は、ファネル型の分業がもたらした帰結でもある。部門の継ぎ目でデータが引き継がれず、買い手から見れば同じ一社とのやりとりが、売り手の中では別々の断片として記録される。
第三に、受注をゴールとしていること。ファネルは受注で終わるが、収益は受注後に始まる。継続、追加購入、他部門への展開、そして紹介。当社の調査では、買い手の77.3%が既存の取引関係の内側で購買を完結させていた。既存顧客こそ最大のリード源であるにもかかわらず、ファネル型のプロセスでは受注後の顧客データが次の売上創出に接続されない。
2-2. レベニューサイクルの定義と全体像
こうした欠陥への回答が、レベニューサイクルである。
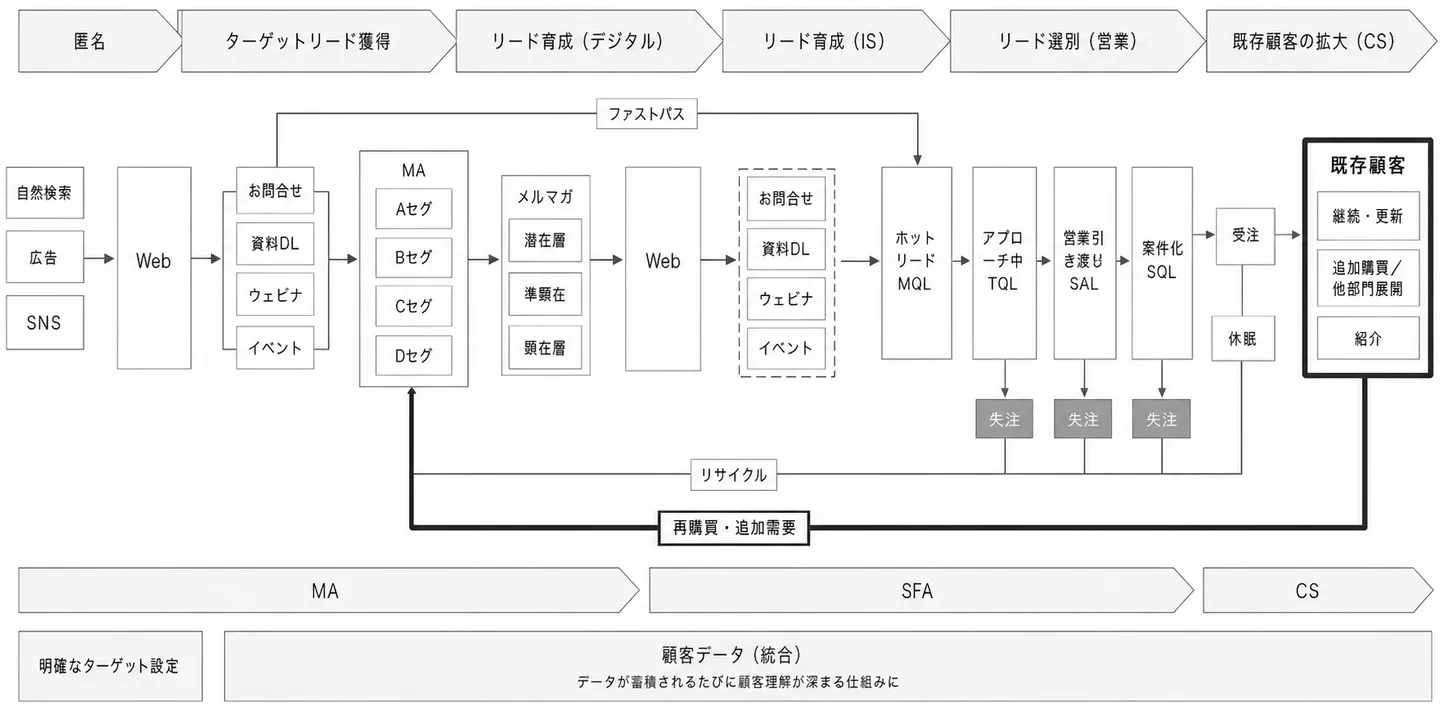
レベニューサイクルとは、リードの獲得→育成→商談→受注→拡大・再購買までを、一つながりの循環プロセスとして捉え、運用するモデルである。
出発点は組織図ではなく、営業リソースの配分である
先に断っておきたい。レベニューサイクルは「マーケティング部門・インサイドセールス部門を新設せよ」という体制論ではない。出発点はあくまで、限られた営業リソースをどこに配分するかという資源配分の問題である。
思考実験として、次の三つの条件が揃う会社を考える。
①営業リソースが潤沢で、すべての見込み客・既存顧客を営業が直接、継続的にフォローできる。
②買い手が検討の初期段階から必ず営業に接触してくる。
③営業組織として管理と徹底がなされている——活動が属人化しておらず、誰が・どの顧客に・何をしたかが可視化され、リードの状況・商談の経緯・判断の根拠が個人の記憶ではなく組織の記録として透明に共有されている。
この三条件が成り立つなら、営業がサイクルの全工程を担えばよく、機能を分ける必要はない。実際、少数の大口顧客と長期取引する事業では、今もこの形が合理的である。
しかし、多くの企業でこの前提は崩れている。
①について。営業リソースは不足し、増強も難しい。一人あたりの担当領域は広がり続け、全リードを営業が均質にフォローすることは現実的に不可能である。
②について。買い手はもう、検討の初期から営業に接触してこない。85%は営業に会う前に候補を絞り込み、最初の接点は検索エンジンとAI検索である。買い手の検討の大半は、営業が届かない場所で進む。
③について。これが最も崩れている条件かもしれない。第1章で見た通り、リードステージの定義(スコア2.23)も実行手順(2.31)も曖昧なまま、活動は個人の力量に委ねられている。顧客情報・商談の経緯・判断の根拠は個人に蓄積され、組織からは見えない。回答者の58.8%が自社の状態を「分からない」と答えた事実は、営業・マーケティング活動の可視化と透明性が確保されていないことの証左である。そして属人化した営業の平準化と質の底上げは、多くの企業で長年の未解決課題であり続けている。
つまりレベニューサイクルにおける機能分担とは、希少な営業リソースを「営業にしかできない仕事」——商談での提案、交渉、関係構築——に集中させるために、それ以外の工程を別の手段で担うという配分の設計である。営業が会う前の認知・育成はマーケティングの仕組みが担い、大量のリードからの選別・一次対応はインサイドセールスが担い、受注後の継続的な接点はカスタマーサクセスが担う。名称や部門の切り方は本質ではない。兼務でも、少人数でも、一部を外部に委ねても構わない。重要なのは、営業が物理的にカバーできない工程を、意図を持って何かに担わせているかどうかである。
サイクルを循環にする三つの要点
この分担を前提に、ファネルとの違いを整理する。要点は三つある。
失注・休眠は「終わり」ではなく「再育成の入口」である。 商談に至らなかったリードも失注案件も、育成の対象として循環に戻す。買い手の検討期間は長く(高価格帯の17.8%が半年以上)、今日の失注が半年後の再検討になる。ここを営業個人の「気が向いたときの掘り起こし」に任せるのではなく、仕組みが接点を維持し続ける。営業リソースをかけずにフォローが継続することに、この設計の意味がある。
既存顧客は最大のリード源である。 買い手の77.3%は既存の取引関係の内側で購買を完結させる。ただしこれは、買い手が惰性で取引先を選んでいることを意味しない。同じ調査で回答者は平均4.4社から提案を受けており(n=94)、比較検討を経たうえで結果として既存取引先が選ばれている。つまり既存顧客に対しても比較の土俵は存在し、そこで選ばれ続けるには利用状況の把握と継続的な接点が必要になる。受注はサイクルの通過点であり、利用状況や組織変化のデータは継続・拡大・紹介という次の収益機会の起点になる。
サイクルが回るほど、データが資産として蓄積される。 一方通行のファネルではリードは消費されて終わるが、循環モデルでは接点のたびに顧客理解が深まる。誰が、いつ、何に反応したか。属人化の対概念はここにある——個人の記憶ではなく組織のデータに蓄積されるからこそ、営業の質の底上げとAIの学習が可能になる。
ただし、この循環には成立条件がある。分担した各機能の間をデータが一気通貫でつながって流れること、そして各接点の定義(リードとは何か、営業に引き渡す条件は何か)が担い手を越えて共通化されていることである。分断されたデータと曖昧な定義のまま機能だけを分けると、営業リソースの節約どころか、部門間の断絶という新しいコストが生まれる。
2-3. AI Readyの定義と、整備がもたらす5つの変化
本書の中心概念を定義する。
AI Readyとは、レベニューサイクルの全体でAIが価値を出せるように、データ・プロセス・組織が整った状態を指す。
具体的には、次の三つの条件を満たすことである。
- データ:顧客・案件・行動のデータが、重複なく・欠落なく・最新の状態で、部門を越えて接続されている
- プロセス:リードの定義、ステージの遷移条件、部門間の引き渡しルールが明文化され、実際にその通り運用されている
- 組織:マーケティングと営業が同じ売上目標を持ち、データの品質とAIの活用に責任を持つ体制がある
なぜこの順番で整える必要があるのかは、第1章で示した通りである。土台の成熟度とAI活用の間には強い相関(r=0.71)があり、土台が未整備な企業のAI活用スコアは1.76、整った企業は2.89と、AIの活用度は土台に従属していた。
AI Ready化が完了したとき、レベニューサイクルには次の五つの変化が起きる。
① AI出力の精度が上がる。 スコアリング、ターゲット選定、提案内容の示唆——AIの判断材料となるデータの品質が、そのまま出力の品質になる。
② 属人業務が自動化され、人が判断に集中できる。 議事録作成、SFA入力、リスト作成といった作業がAIに移り、営業は顧客との対話と判断に時間を使える。リソース不足への現実的な回答は、採用ではなく一人あたり生産性の再設計である。
③ 部門間の分断が解消され、リードの取りこぼしが減る。 データが一気通貫でつながれば、営業がフォローしきれないリードをインサイドセールスとMAが引き取る循環が機能する。死蔵リードの再活性化は、新規獲得よりも低コストな収益源になる。
④ 意思決定が速く、正確になる。 パイプラインの状況、案件の確度、施策の効果がリアルタイムに可視化され、経験と勘に頼らない判断ができる。第1章で見た「経営・中間・現場がバラバラの自社像を見ている」状態から、全社が同じ数字を見る状態への転換である。
⑤ 一度整えれば、すべてのAIユースケースに効く。 スコアリングも、コンテンツ生成も、商談要約も、同じデータ基盤の上で動く。ユースケースを一つ追加するたびに環境をつくり直す必要はない。AI Ready化は個別施策ではなく、以後のあらゆるAI投資の回収率を引き上げる基盤投資である。
2-4. どこから整えるか——本書のルート
AI Readyの三つの条件——データ・プロセス・組織——を示した。では、どこから手をつけるべきか。
本書の答えは、データからである。理由は二つある。
第一に、依存関係の問題である。プロセスの改善もAIの活用も組織の意思決定も、すべてデータを前提に動く。リードの引き渡しルールを精緻に設計しても、渡されるリードのデータが重複・陳腐化していれば機能しない。逆に、データが整っていれば、プロセスとAI活用の改善は加速する。土台の成熟度とAI活用の相関(r=0.71)が示していたのは、この依存関係である。
第二に、データは三条件の中で唯一、放置すると劣化し続けるという性質を持つ。プロセスや組織のルールは、一度定めれば急には壊れない。しかしデータは、日々の業務——名刺の取込、フォームからの流入、システム間の連携、担当者の異動——から絶えず汚染が流入し、何もしなくても品質が下がっていく。多くの企業がMA/SFAを導入済みでありながらツールカテゴリの成熟度が最下位(2.36)である理由は、ここにある。導入時に整えたはずのデータが、運用の中で使えない品質に戻っているのだ。
したがって、データ整備の起点は「基盤を構築すること」ではない。汚染がどこから発生しているかを特定し、発生源を断つことである。発生源を放置したまま構築した基盤は、完成した瞬間から劣化が始まる。
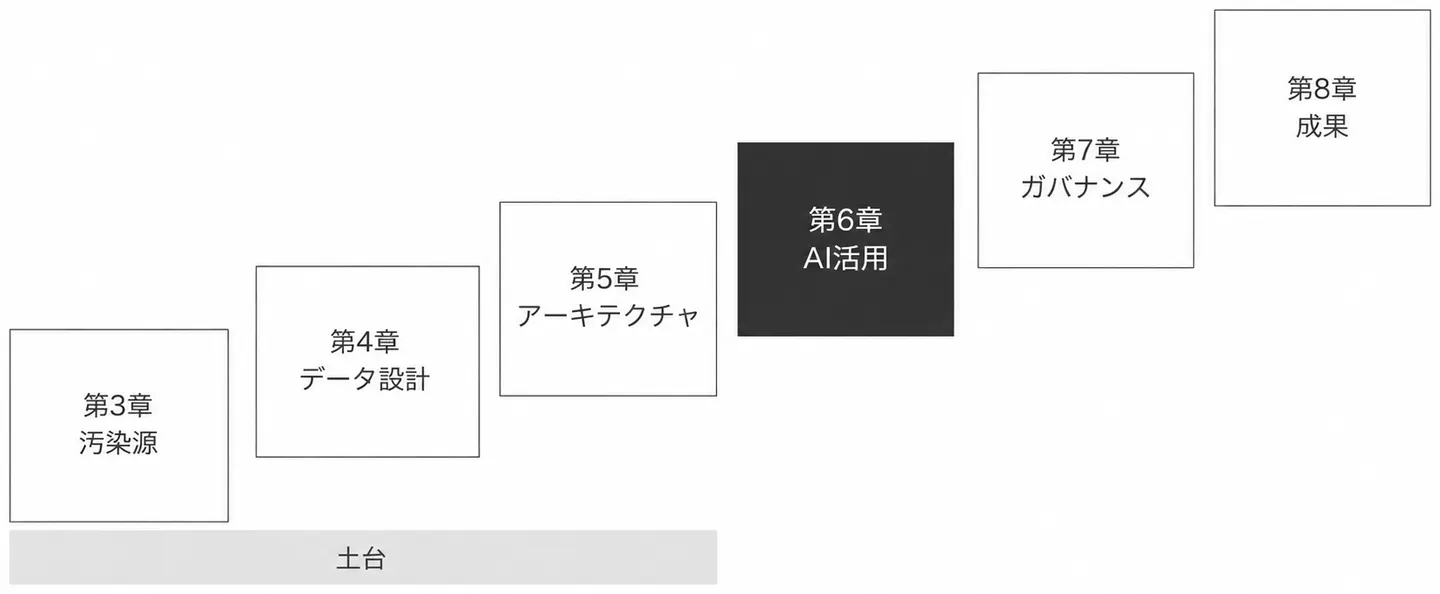
以上を踏まえ、本書の後半は次のルートで進む。まず汚染の発生源を特定し(第3章)、汚染を排除したデータの持ち方を設計し(第4章)、それを載せる器を選び(第5章)、その上でAIを動かし(第6章)、全体を維持する体制を整え(第7章)、成果に接続する(第8章)。各章は前の章を前提に積み上がるため、順に読み進めることを推奨する。