第5章 GTMエンジニアリングの4つのレイヤー
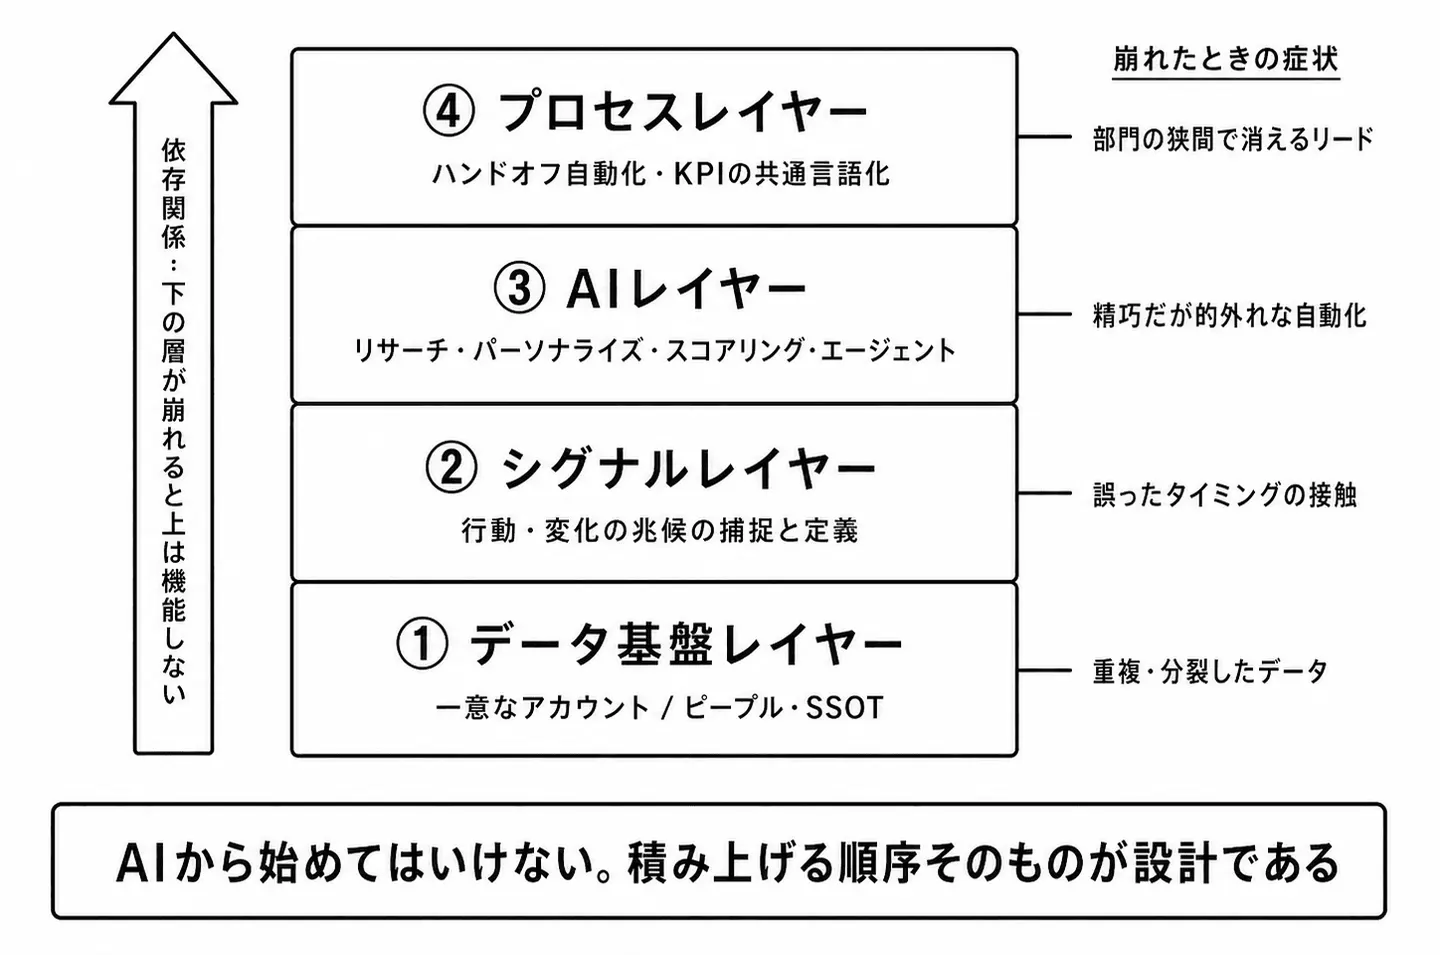
本章では、GTMエンジニアリングGTM EngineeringGo-To-Market EngineeringGTM戦略の7つの工程を、テクノロジーとAIで標準化し、自動化し、精度を上げ続けることで、完遂し、グロースさせる手段。多くの企業で欠けている、ターゲットと施策の間の工程を仕組みにする。用語集で見る →が構築する対象を、土台から順に4つのレイヤーとして解説する。繰り返しになるが、この4層は下から積み上がる依存関係にある。上位レイヤーの華やかさ(AI、自動化)に目を奪われる前に、足元のレイヤーが成立しているかを常に問う必要がある。
5-1 レイヤー①データ基盤――SSOTをどこに、どう作るか
第3章の工程04で述べた通り、データ基盤の要諦は「アカウント(企業)とピープル(人)の一意性担保」と「データが自動的に集まる構造」である。本節では一歩踏み込み、そのSSOTSSOTSingle Source of Truth項目ごとに「どこが正か」が一意に定まった状態。全データを1箇所に集めることを意味しない。用語集で見る →をどこに構築するかというアーキテクチャの選択を論じる。選択肢は大きく2つある。
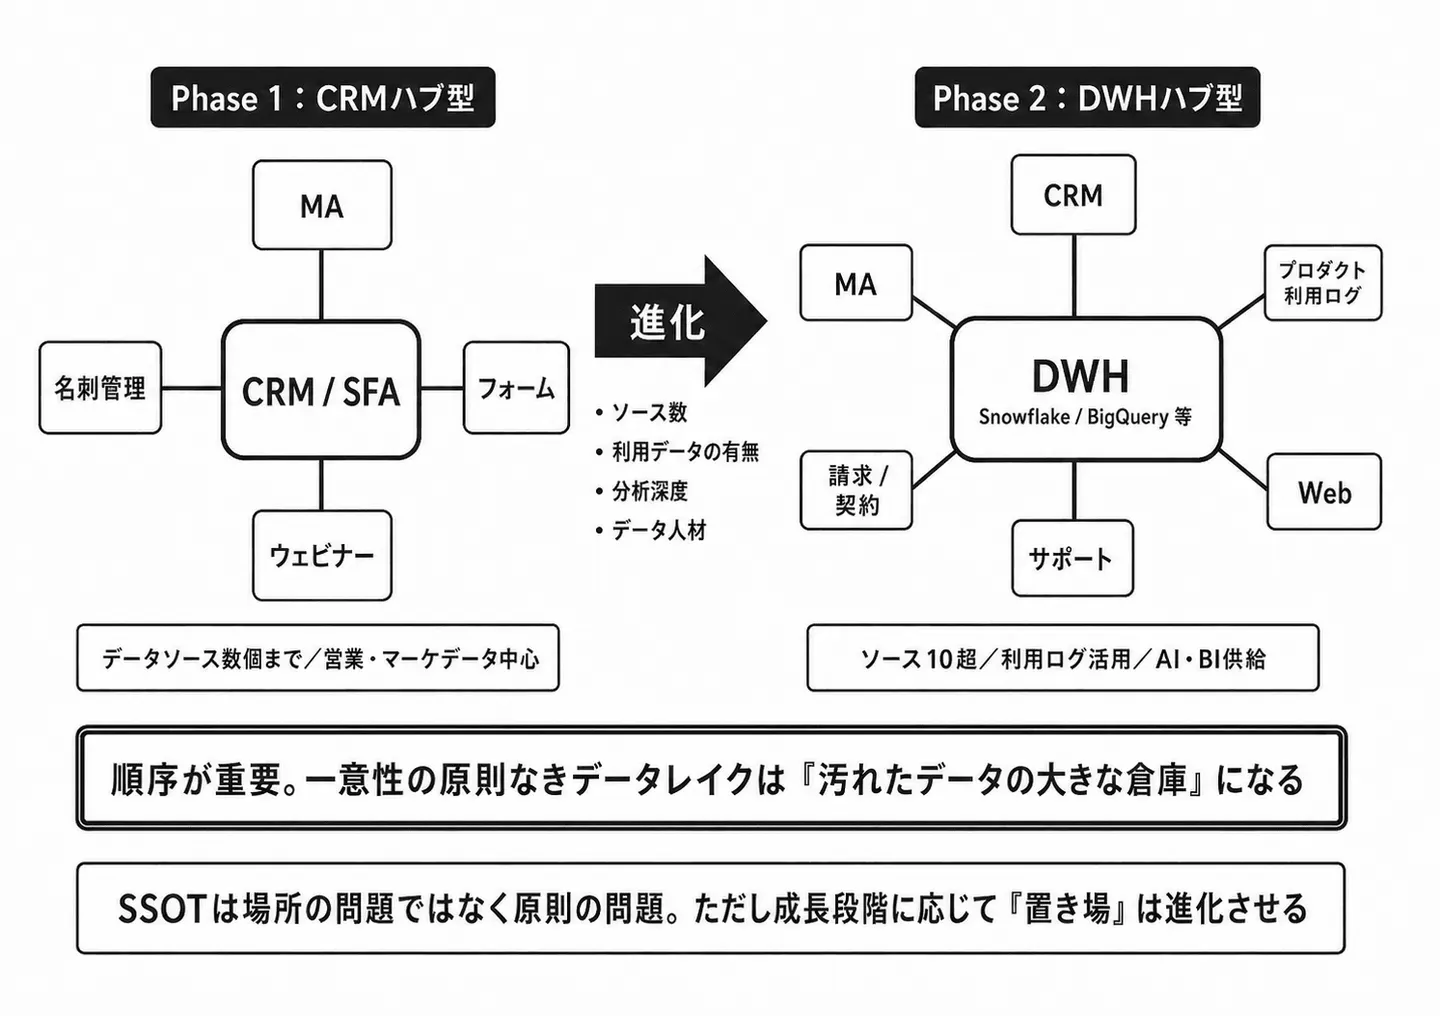
CRMCRMCustomer Relationship Management顧客との関係と取引履歴を管理する仕組み。GTMの4レイヤーでは、SFA・MAと並ぶ業務アプリケーション層に位置づけられる。用語集で見る →ハブ型。 Salesforce等のCRM/SFASFAセールスフォースオートメーション営業の実行と管理のための業務アプリケーション。用語集で見る →をデータのハブとし、MAMAマーケティングオートメーションマーケティングの実行と管理のための業務アプリケーション。用語集で見る →・名刺管理・フォーム・ウェビナーツールなどをCRMに接続してSSOTを構成する。マーケティングから営業までのデータが中心で、扱うデータソースが数個程度の企業であれば、この構成で十分に機能する。利点は、営業・マーケの現場が日常的に見る画面とSSOTが一致すること、追加のデータ人材を必要としないこと。多くの日本のBtoB企業にとって、現実的な出発点はここである。
DWHDWHデータウェアハウス複数システムのデータを蓄積・統合・加工するためのデータ基盤。用語集で見る →/データレイクハブ型。 Snowflake、BigQueryといったデータウェアハウス(DWH)をハブとし、CRM・MAに加えて、プロダクト利用データ、請求・契約データ、サポート履歴、広告データまでを統合する構成である。海外ではこの「warehouse-native GTMGTMGo-To-Market製品・サービスを市場に届けて収益化するまでの一連の設計。日本語圏では Google Tag Manager と略称が重なるため、文脈に注意が要る。用語集で見る →」への移行が進んでおり、顧客データ基盤(CDP)の機能をDWH上に構成する「コンポーザブルCDP」と呼ばれるアプローチも一般化しつつある。利点は、CRMには収まらない大量・多種のデータ(例:日次のプロダクト利用ログ)を扱えること、BIBIビジネスインテリジェンスデータを可視化して意思決定に使えるようにする仕組み。ダッシュボードや経営レポートがこれにあたる。用語集で見る →・機械学習・AIエージェントへの供給源を一本化できること。代償は、データエンジニアリングの人材・運用コストである。
重要なのは、どちらが正解かではなく、移行の順序である。判断基準は次の4つ。
- データソースの数:接続すべきソースが数個ならCRMハブ、10を超えて増え続けるならDWHを検討
- プロダクト利用データの有無:PLGPLGProduct-Led Growth製品自体の無料利用体験を入口にするGTMモーション。セルフサーブで価値を体感できる商材に向く。利用ログを営業シグナルとして使えるかが、データ基盤の要否を分ける。用語集で見る →要素があり利用ログを営業シグナルシグナル顧客企業に起きた変化を示す情報。経営方針・組織・キーパーソン・採用・投資と業績・事業・導入ツールと体制・外部環境の変化があり、多くは公開されている情報から得られる。用語集で見る →に使いたいなら、DWHがほぼ必須
- 分析・AI活用の深度:定型レポートで足りるか、横断的な分析・予測・エージェント供給まで必要か
- データ人材の有無:DWHハブは構築より運用が本番であり、担い手なしに建てたDWHは「誰も見ない倉庫」になる
陥りがちな失敗は両極にある。ひとつは「最初からデータレイクありき」のオーバーエンジニアリング。一意性という原則が確立していない段階で器だけ大きくしても、汚れたデータの置き場が増えるだけである。もうひとつは、CRMハブの限界(ソース増加、ログデータ)に達しているのに増改築を重ねて複雑化させる停滞である。実務的な段階論はこうなる――まずCRMハブで一意性とSSOTの原則を確立し、データソースと活用要件が閾値を超えた時点でDWHハブへ進化させる。その際、CRMは「捨てる」のではなく、DWHと双方向同期する現場の操作面として生き続ける。
5-2 レイヤー②シグナル――「今、この企業に話す理由」をデータにする
データ基盤の上に構築するのが、シグナルレイヤーである。第3章の工程05で述べたコンテキストコンテキストその顧客が今どんな状況にあり、なぜそれを求めているのかを説明するための情報。業種や規模と違い一社ごと・一人ごとに異なり、シグナル・自社接点・購買グループを組み合わせて組み立てる。用語集で見る →の材料のうち、「なぜ今か」を担う層にあたる。シグナルとは、顧客側の行動や状態の変化のうち、「今アプローチすべき理由」を示す兆候を指す。
BtoBの買い手は、売り手が接触するはるか前から自分で情報収集を進めている。物量で網を張るのではなく、変化の瞬間を捕捉して適切に接触する――これがシグナル起点のアプローチであり、第2章で見た「SDRSDRSales Development Representative見込み客への初期接触と商談化を担う役割。インサイドセールスのうち、新規開拓側を指すことが多い。用語集で見る →物量モデルからの転換」の中身である。シグナルの例を挙げる。
- 自社への行動シグナル:価格ページの再訪、資料の複数ダウンロード、休眠顧客のサイト再訪、ウェビナー参加
- 企業の変化シグナル:関連職種の求人開始、組織変更・役員就任、資金調達や中期計画での投資テーマ、拠点展開
- 利用状況シグナル(既存顧客):プロダクト利用の急増・急減、活用範囲の拡大、更新期限の接近
このレイヤーの設計で最も重要な原則は、自社で意味を説明できるシグナルを優先することである。外部ベンダーが提供するブラックボックス化したインテントスコアを盲信するより、「価格ページを1週間に2回見た企業は商談化商談化リードが営業の対応する案件になること。ここで購買グループの関心・懸念が一人分に縮むと、以降の設計が効かなくなる。用語集で見る →率が高い」という自社データで検証可能な定義の方が、改善のループを回せる。シグナルは「買う」ものではなく「定義し、検証する」ものだ。
そしてこの検証が成立する前提こそ、レイヤー①の一意性である。同一企業が3レコードに分裂していれば、行動シグナルも3つに分裂し、閾値に達しない。シグナルの精度は、データ基盤の品質の従属変数なのである。
5-3 レイヤー③AI――判断と作業を移植する
第三のレイヤーが、AI(主に生成AI/LLM)の実装である。GTMにおけるAI活用は、2つの方向で急速に実用化した。
第一は、作業の自動化。 接触前の企業リサーチ(事業内容、直近の発信、決算情報の要約)、シグナルと文脈を踏まえたパーソナライズ文面の生成、商談メモの要約とCRMへの記録、リードスコアリングリードスコアリング見込み客の属性や行動を点数化して、優先度を判断する仕組み。用語集で見る →。従来SDRやマーケ担当者の時間を大量に消費していた定型作業が、AIに委譲可能になった。
第二は、判断の移植。 より本質的なのはこちらである。第2章のVercel事例が示した通り、トップパフォーマーの優先順位づけ・文脈の読み方・アプローチの組み立て方を観察し、プロンプトとワークフローに翻訳することで、「優秀な個人の暗黙知」を「組織のシステム」に変換できる。2026年時点の潮流は、単発のルールベース自動化から、ガードレール(許可された範囲・停止条件)の中で自律的に文脈を解釈し実行するAIエージェント型へと移行しつつある。
ただし、このレイヤーには明確な警告が要る。AIは下位レイヤーの欠陥を増幅する。汚れたデータの上のAIは、誤った相手に、精巧で丁寧な誤ったメッセージを、高速かつ大量に送る。手作業の時代には1日数十件で済んだ誤りが、自動化によって数千件規模になる。AIレイヤーの導入判断は「AIで何ができるか」ではなく「AIに渡せる品質のデータとシグナルがあるか」から始めなければならない。
5-4 レイヤー④プロセス――部門の狭間を技術で埋める
最後のレイヤーは、部門横断プロセスの実装である。どれだけ良いリードを生み、精巧なAIを組んでも、リードが部門の狭間で消えるなら収益にはならない。ここで実装するのは主に2つである。
ハンドオフハンドオフマーケティングから営業へなど、部門をまたいでリードや案件を引き渡すこと。条件を決めずに運用すると、取り逃しと差し戻しが起きる。用語集で見る →の自動化。 第3章の工程02で定義した引き渡し基準(どの条件を満たしたらマーケからインサイドセールスインサイドセールス訪問せずに電話やメールで見込み客と接点を持つ営業機能。聞き取りで得た情報は、フォームからは分からない購買グループの手がかりになる。用語集で見る →へ、インサイドセールスから営業へ渡すか)を、人の申し送りではなくシステムの自動判定・自動通知・自動割り当てとして実装する。SLASLAService Level Agreementリードの引き渡し条件・対応期限・差し戻し基準など、部門間で交わす合意。用語集で見る →(対応期限の合意)も、期限超過の検知とエスカレーションまで自動化して初めて実効性を持つ。
定義の共通言語化。 「リード」「商談」「案件確度」の定義を全部門で統一し、システム上の項目とステージとして固定する。地味に見えるが、これはAI時代においてむしろ決定的である。定義がバラバラなデータでは、人間の会議が紛糾するだけでなく、AIも誤った学習と判断をする。第2章で触れた通り、先行企業がデータの用語・定義の統一に投資しているのは、AIに業務を任せるための土台作りに他ならない。
このレイヤーが完成すると、第3章で描いたレベニューサイクルレベニューサイクルリード獲得から受注後の拡大・再購買までを、一つながりの循環プロセスとして捉える収益モデル。用語集で見る →(マーケ→IS→営業→CSの連携)は、努力目標ではなく、システムが担保する構造になる。
5-5 4レイヤーの統合――「深く統合された少数」が勝つ
最後に、4レイヤーを貫く統合の原則を確認する。第2章で紹介した通り、12以上の分断されたツールを持つチームは、深く統合された4〜5ツールのチームに一貫して劣後する。レイヤーを増やすことは、ツールを増やすことではない。むしろ逆で、一意なデータ基盤の上に、シグナル・AI・プロセスが同じデータを参照して動く状態を作ることが統合の意味である。
自社の現状を診断する問いはシンプルだ。「わが社のツールたちは、同じ顧客を、同じIDで、同じ定義で見ているか?」――この問いにイエスと答えられないなら、次に投資すべきは新しいツールではなく、レイヤー①である。